ReAct 和 tool call
TODO
5. 第一批工具怎么设计
1) 为什么要有 edit_file
2) 模型抄错了片段怎么办
跑久了会发现,模型给的 old_text 经常和文件差一点点。文件里是弯引号,模型写成了直引号;文件行尾多了几个空格;最常见的是把 read_file 输出里的行号前缀 12 | 一起抄了过来。
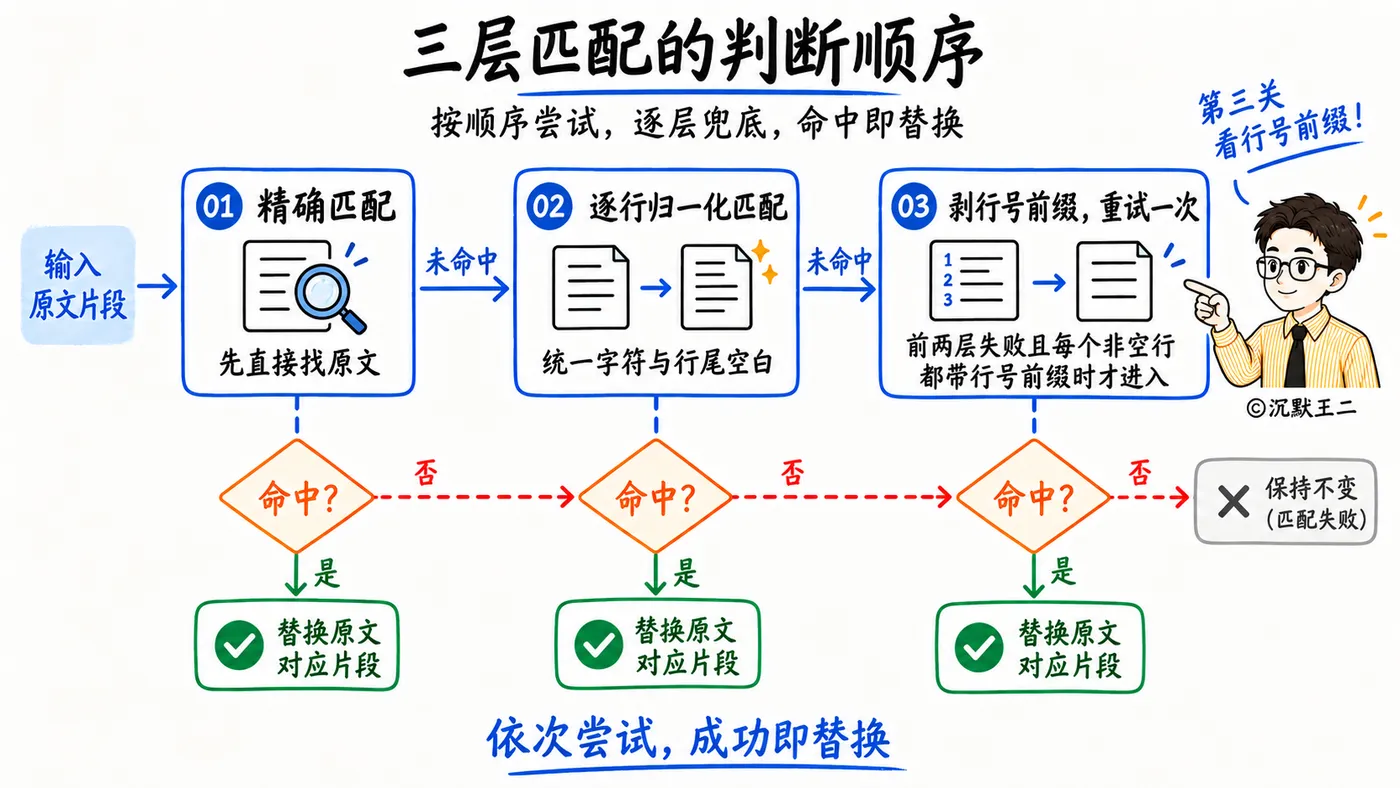
MiniMax Code(MiniMax 开源的终端编程 Agent)的 edit 工具专门处理了这几类误差,PaiCLI 参考它做了三层匹配。
1 | // src/main/java/com/paicli/tool/TextEditMatcher.java(节选) |
第一层是精确匹配。文件用的是 Windows 的 CRLF 换行、片段只有 \n 时,会按 CRLF 再匹配一次,替换后保留文件原来的换行风格。
第二层是逐行归一化。文件和片段都做同样的处理,全角字符按 NFKC 转成半角,去掉每行末尾的空白,弯引号换成直引号,各种长短横线换成 -,各种特殊空格换成普通空格。在归一化后的文本里找到位置,再映射回原文,只替换原文里对应的那一段。
- 映射回原文时有一道检查。归一化可能把一个字符展开成两个,比如连字 fi 会变成 fi,片段只命中其中的 i 时,工具会拒绝,不做半个字符的替换。
前两层都在 try 中的
applyOnce方法实现。第三层由 catch 异常处理实现。
第三层是剥行号前缀。它只在前两层都失败、并且片段里每个非空行都带行号前缀时才触发,剥掉之后重试一次。
条件定得这么严,是因为有些文件的内容本身就长得像带行号,比如日志或者 Markdown 表格。先走精确匹配,这类文件照常能改。
replace_all 只走精确匹配。批量替换本来就有风险,再叠一层模糊匹配,改错的范围会跟着变大。
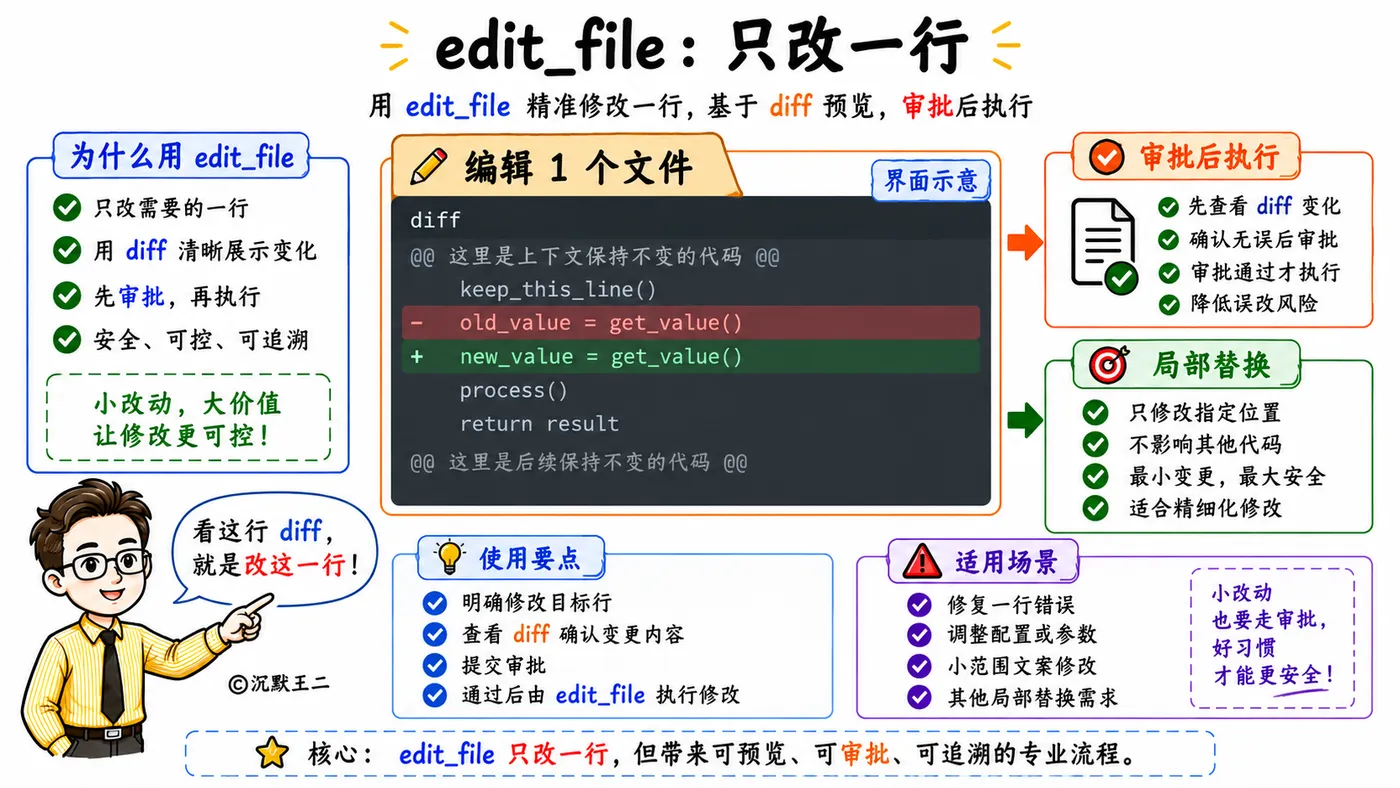
切到 ask 模式(人工审批,也叫 HITL,Human-in-the-Loop)后,edit_file 执行前会弹出审批框,编辑成功后终端里会显示一段 diff。
3) execute_command 的边界
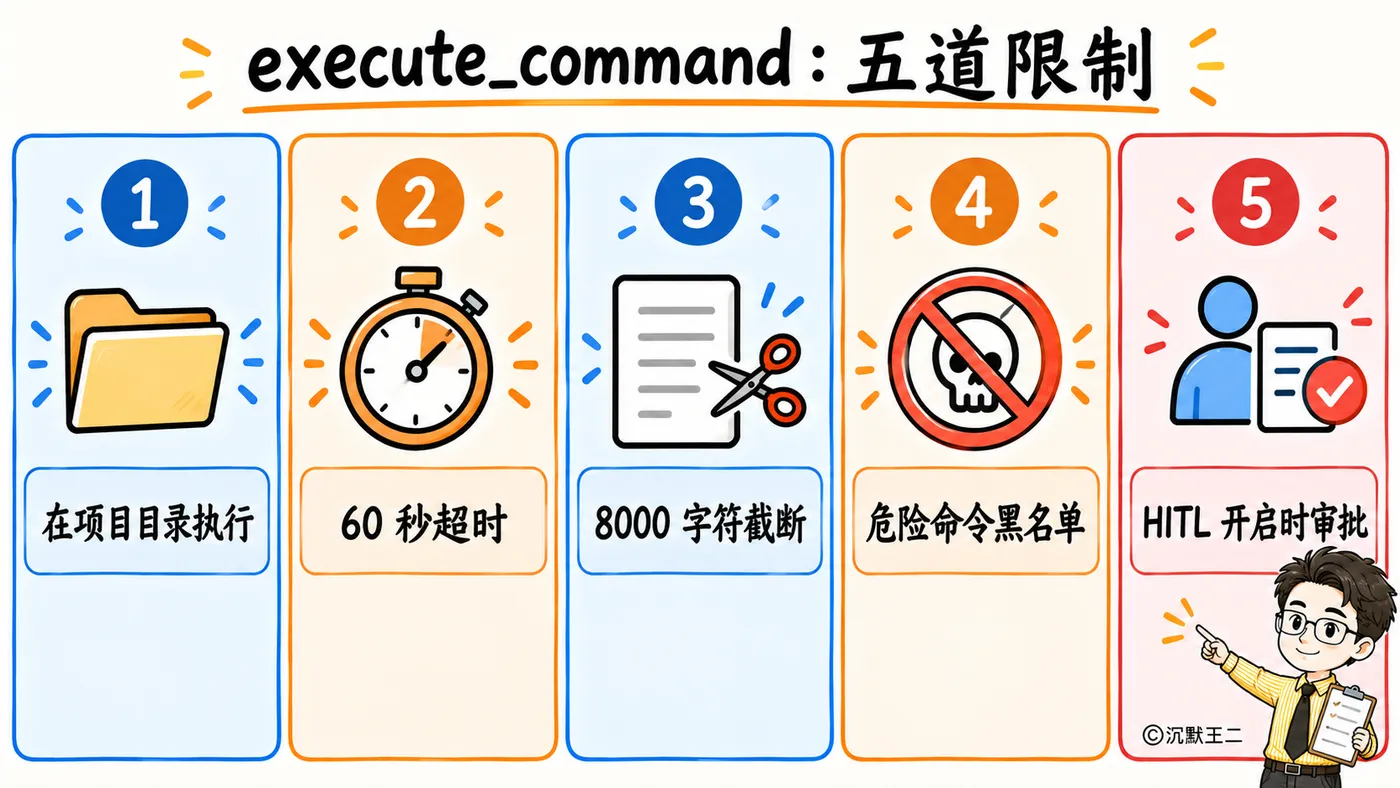
execute_command 是最有用、也最危险的工具。它在项目目录里用 bash -c 执行命令,60 秒没结束就强制终止。输出超过 8000 字符时,完整输出默认写进文件,对话里只保留截断后的部分。
命令执行前会过一遍黑名单,sudo、对根目录和家目录的 rm -rf、mkfs、curl | sh 这类命令直接拦下。这份黑名单只是辅助手段,正则总有绕过去的写法。
真正的把关在审批环节。PaiCLI 启动后默认处于 auto 模式,写文件、编辑文件直接执行,每条 Shell 命令则先交给一个轻量模型分类器审查。分类器只看用户这一轮的原话和命令本身,看不到网页和文件内容;它判定只读、低风险才直接执行;判定有风险或者审查出了问题,命令不会执行,拒绝原因作为工具结果交回给模型,让它换一种做法,或者在回复里向用户说明为什么需要这条命令。MCP 工具和回滚快照在 auto 下也是同样处理。模型在同一轮里连续被拦到第 3 次,才会弹出审批框交给用户决定。
想让每个危险操作都经过人工确认,就按 Shift+Tab 切到 ask 模式,或者输入 /hitl on。Shift+Tab 在 auto、plan、ask 三个模式之间循环,状态栏左侧会显示当前模式。交互式命令行里没有“全部放行”的档位,最宽松就是 auto。
6. 循环什么时候停
主循环没写轮数上限。
长上下文模型一次任务连着调用几十次工具很正常,写死 10 轮或者 50 轮,复杂一点的任务可能还没做完就被截断了。所以 PaiCLI 默认让模型自己决定什么时候停。
不设上限,就得防着模型原地打转。同一个命令跑了一遍又一遍,同一个网页抓一次失败一次,PaiCLI 用两道关卡处理这种情况。
1) 先提醒
这道关卡参考了 MiniMax Code 的重复检测。每一步工具调用结束后,程序检查两类重复。
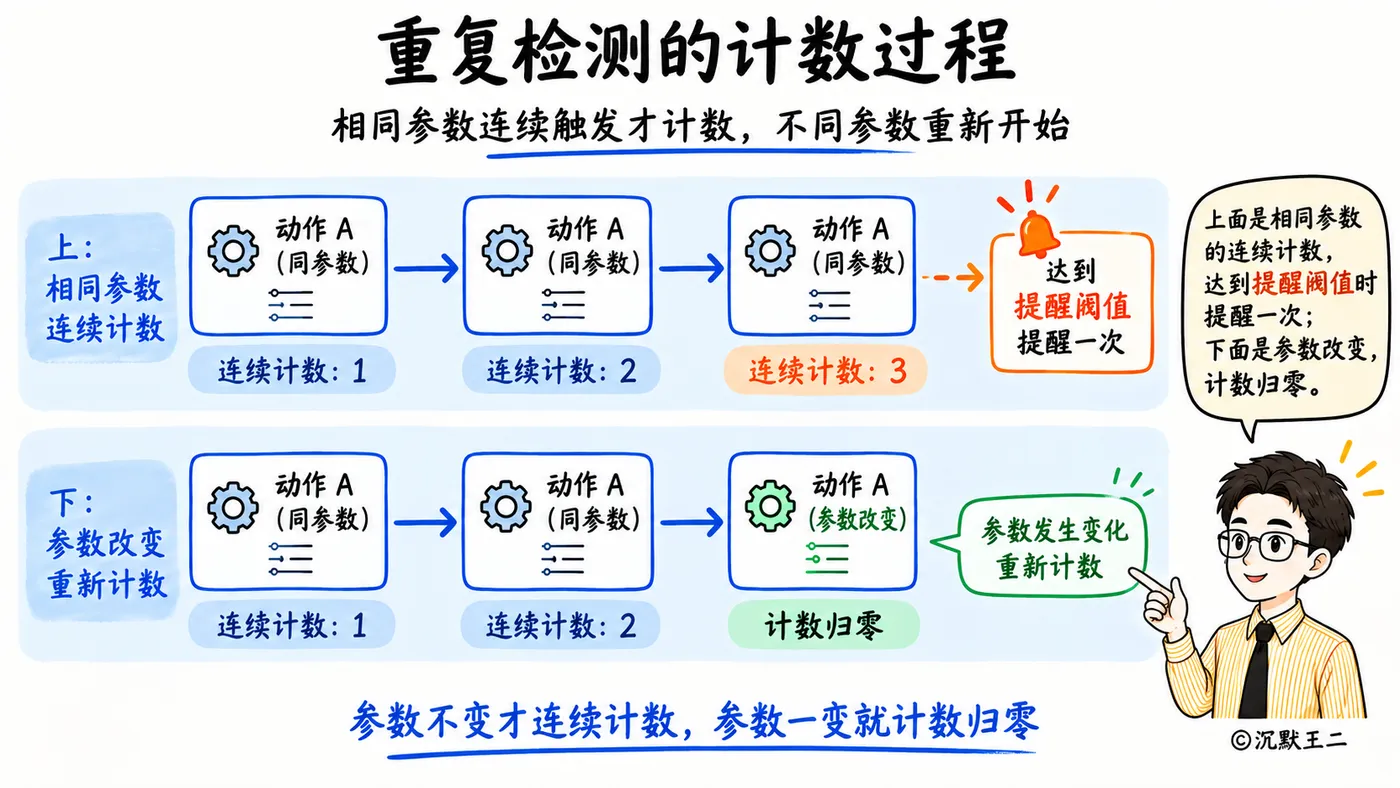
一类是同一个动作连续出现,工具名相同、参数相同。参数会先按键名排好序再比较,模型只是换了键的顺序,也算同一个动作。
另一类是同一类错误连续出现。错误按文本归类,超时、限流、网络、鉴权、权限、找不到、参数错误、进程退出码各算一类,归不进去的按错误文本本身比较。
某个动作只要在中间某一步没出现,连续计数就归零。连续达到 3 步,就在工具结果后面追加一条提醒。
1 | // src/main/java/com/paicli/agent/RunawayGuard.java(节选) |
模型收到的提醒是这样的。
2
3
4
先看已经拿到的结果,然后换一个策略并说明预期会带来什么具体变化,或者说明卡在了哪里。
重复本身不能说明任务已经完成,也不能说明任务无法完成。这是只对本次任务有效的临时运行提醒,
不是用户偏好,也不是长期规则;不要保存它,也不要把它总结进长期记忆、Skill 或其他持久化指令。
每次任务最多提醒一次,不拦截任何工具。被策略拦下或者用户拒绝的调用没有真正执行,不计入重复。
为什么先提醒、不直接停?
重复不一定是死循环。等一个还在编译的构建、网络抖动时重试一次,前几次重复都说得过去,直接停掉会把已经做完的工作一起丢掉。提醒让模型自己判断要不要换一条路。
提醒里专门写了只对本次任务有效。PaiCLI 有长期记忆,模型要是把这条提醒当成用户偏好存下来,以后每次任务都会带着它,那就麻烦了。
2) 兜底收尾
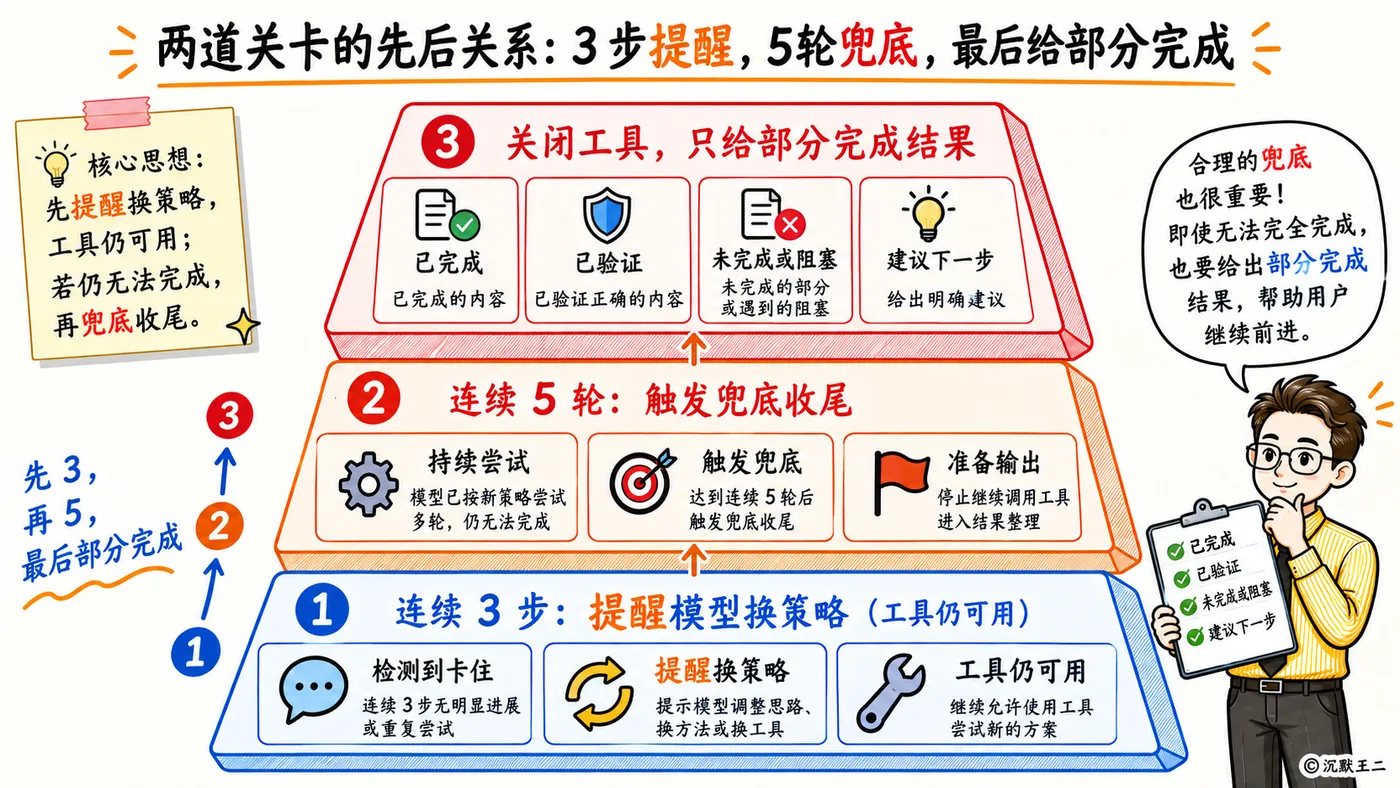
模型被提醒之后,还原样重复到连续 5 轮,程序就不再给它机会了。它会关掉所有工具,再请求模型一次,让它基于已有结果收尾。
1 | // src/main/java/com/paicli/agent/AgentBudget.java,finalizationInstruction 节选 |
这次请求传的是空的工具列表,模型想调也调不了。返回的结果前面会加上“⚠️ 部分完成”,用户一眼就知道任务没有全部做完,也能看到卡在了哪里。
兜底的窗口是 5,提醒的阈值是 3,窗口必须比阈值大,否则提醒还没发出去循环就停了。测试里有一个用例专门守着这个大小关系。
除了重复检测,Token 预算和轮数上限也能触发同样的收尾。它们默认都不限制,CI 或者微信这类无人值守的场景,可以用 -Dpaicli.react.token.budget 和 -Dpaicli.react.hard.max.iterations 显式打开。
7. 跑起来看看
PaiCLI 需要 Java 17 以上和 Maven,外加至少一个模型的 API Key。我们首选 DeepSeek,默认模型是 DeepSeek V4.1 Flash(模型 ID deepseek-flash),1M 上下文,支持思考模式、工具调用和图片输入。
模型迭代很快,后续 PaiCLI 的默认模型可能还会继续升级,大家自己记得升级。
2
3
mvn clean package # 默认跳过测试
java -jar target/paicli-1.0-SNAPSHOT.jar启动后默认使用 DeepSeek,没配 DeepSeek 的 Key 时,会按顺序找 GLM、混元、Kimi 等其他已配置的模型,运行中也可以用
/model切换。![image]()

先试试第 1 节的例子,让它读一个文件再改一行。
1 | 读取 demo/Hello.java,把输出改成 Hello PaiCLI |
Plan 和 DAG
给 Agent CLI 加上 Plan-and-Execute,让 Agent 先规划后执行,支持 DAG。
第 1 期的 ReAct 已经能干活了,读文件、改代码、跑命令,一步接一步。
可任务一长,比如“读 pom.xml、看看源码结构、再写一份升级方案”,问题就来了。我们在 Agent 动手之前不知道它打算怎么做,互不相干的几步也没法同时跑。中途哪一步错了,只能等它自己发现。
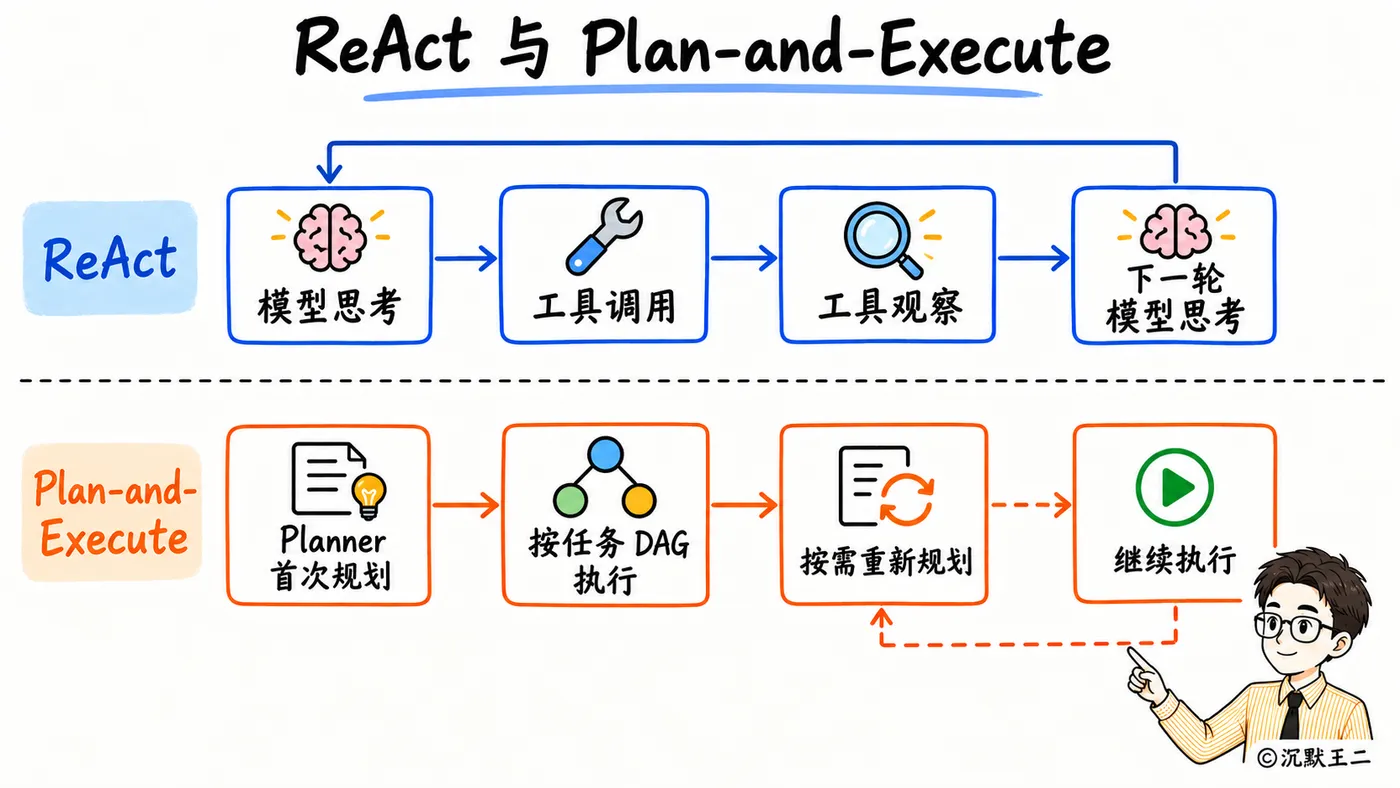
这一期我们给 PaiCLI 加上 Plan-and-Execute。模型先出一份带依赖关系的任务清单,我们确认之后,PaiCLI 按依赖分批执行这些任务,互不依赖的任务还可以并行。
这是二期重构后的教程版本,一期未重构之前的翻到后面,会更简单,更容易懂。二期做了很多加固和升级。
为什么要通过两遍扫描去处理 LLM Plan 中的前向依赖
如何实现动态重规划
当前规则是:任务失败且完成度低于 50% 时尝试重新规划,默认最多 2 次;完成度达到 50% 时,跳过依赖失败节点的后续任务,继续处理不受影响的任务。达到重规划上限后停止启动新任务。
1. 先规划再执行
Plan-and-Execute 把一次任务交给两个角色。规划器(Planner)负责出计划,它调用模型时不给任何工具,只要求模型输出一份 JSON 格式的计划。执行器(PlanExecuteAgent)拿着这份计划,按依赖关系一批一批地跑任务。
- 正常情况下规划器只调用一次模型;用户审阅时补充要求,或者任务失败后需要重新规划,规划器会再调用模型。
“Plan 模式”在不同产品里做法不一样。Pi 是一款开源的终端编程 Agent,它的 Plan 模式只做只读调研,通过
setActiveTools把 edit 和 write 两个写文件工具拿掉,bash 也只放行只读命令。PaiCLI 的做法不同,只有规划器调用模型时不带工具,执行器执行每个任务时,读写文件、执行命令这些工具都照常可用。两种做法的对比可以阅读《Plan模式死了吗?》
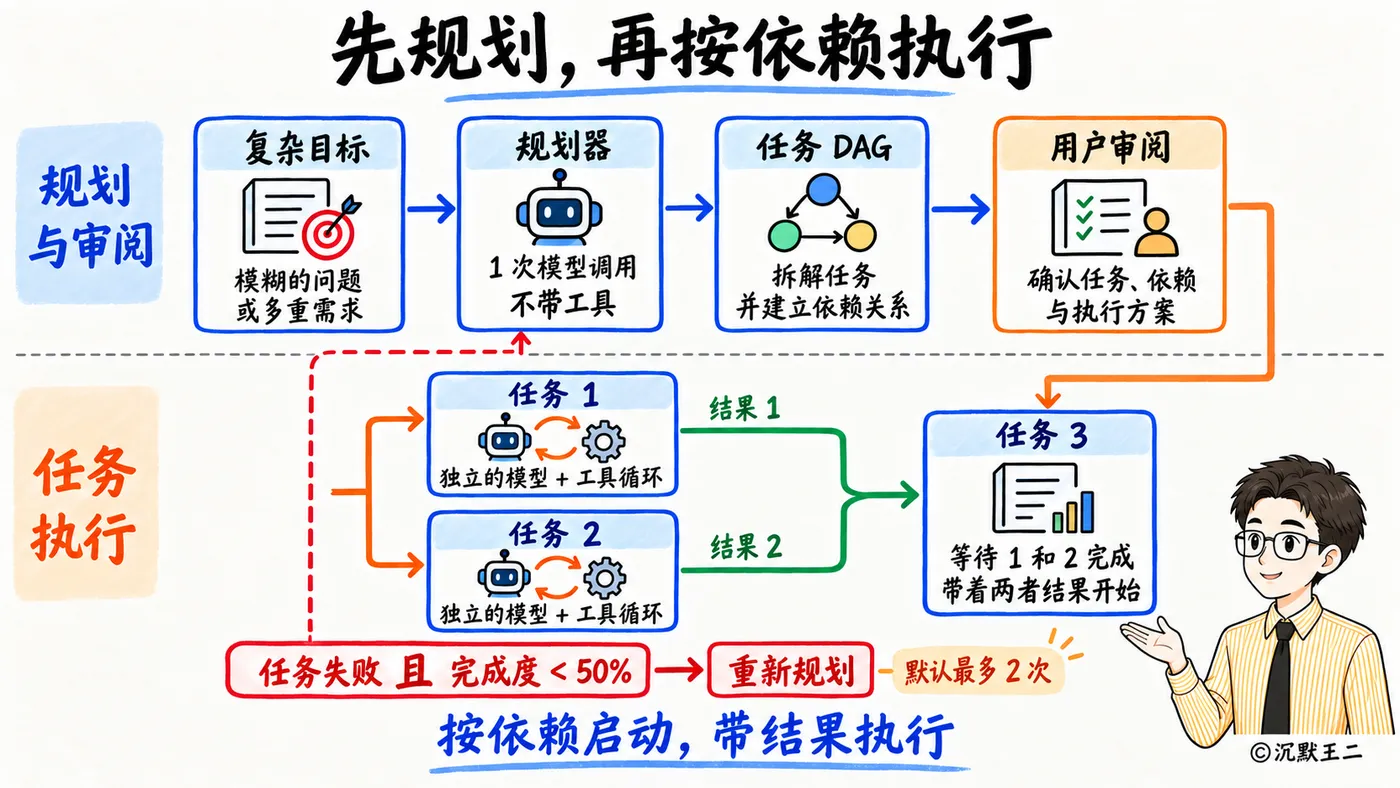
每个任务内部,跑的还是第 1 期 ReAct。模型决定调用什么工具,工具结果交回模型,直到模型不再调用工具,这个任务就算完成。
在 Agent 开始动手之前,我们能看到完整的计划,可以确认、补充要求或者直接取消。读 pom.xml 和列出 src 目录这种没有先后关系的任务,可以同时跑。每个任务拿到的上下文也更干净,只有总目标、任务描述和直接依赖的结果。
两种模式放在一起比一下。
| 对比项 | ReAct | Plan-and-Execute |
|---|---|---|
| 模型调用次数 | 由 Action 轮数决定 | 多一次规划,每个任务至少一次 |
| 耗时 | 取决于 Action 轮数 | 多一次规划等待,独立任务并行时可能更快 |
| 执行前能否看到步骤 | 不能 | 能,还能补充要求后修改计划 |
| 适合的任务 | 简单任务、边看边决定的探索 | 步骤多、依赖明确、想先看清流程的任务 |
2. 计划长什么样 DAG
一个任务就是一个节点。
1 | // src/main/java/com/paicli/plan/Task.java |
任务类型有 5 种,FILE_READ、FILE_WRITE、COMMAND、ANALYSIS、VERIFICATION。执行任务时,任务类型会填进发给模型的提示词里,提醒模型这一步是读任务、写任务还是分析任务。类型不限制模型能用哪些工具。
dependencies 记录这个任务依赖哪些任务,用来判断它能不能开始执行;dependents 记录哪些任务依赖它,这个任务失败时,顺着 dependents 就能找出所有受影响的任务。下文把依赖某个任务的任务叫作它的“下游”。
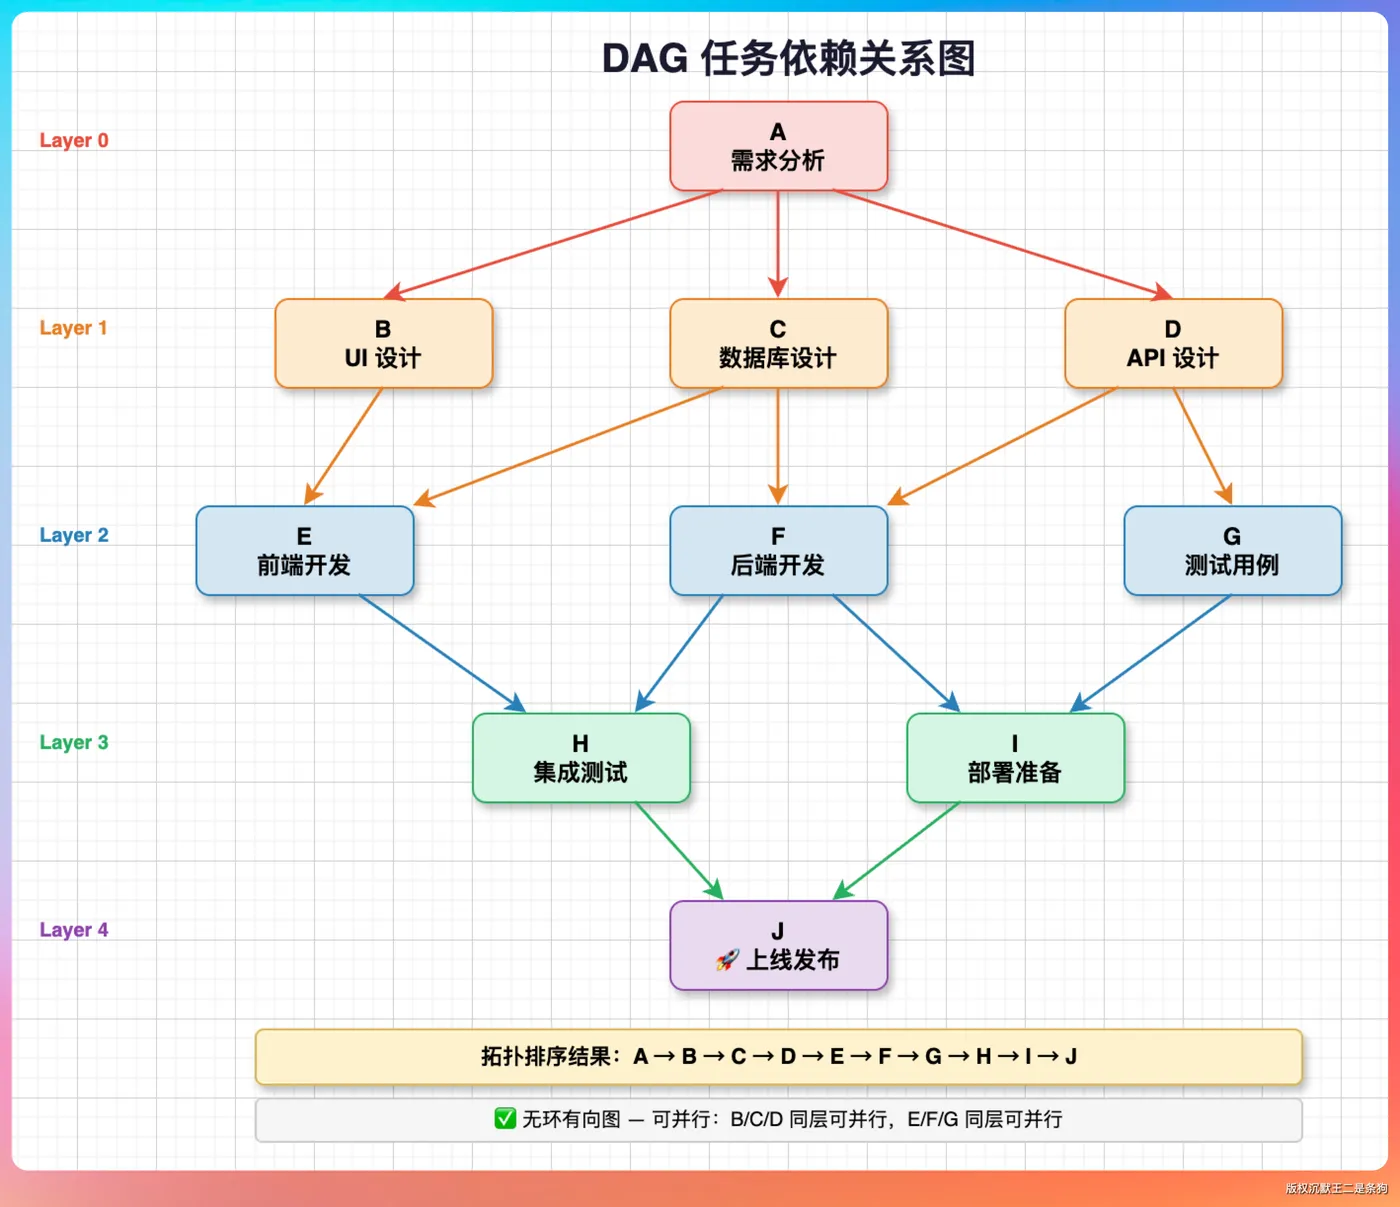
任务状态有 5 种。
1 | PENDING → RUNNING → COMPLETED / FAILED |
能不能开始执行,只看一个条件,所有依赖是否都已经完成。
1 | // src/main/java/com/paicli/plan/Task.java |
依赖失败或者被跳过,下游会等不到 COMPLETED,所以失败处理必须主动把下游标成 SKIPPED,不然会一直停在 PENDING。
并行执行时有两类线程。调度线程是运行执行器主循环的那个线程,任务的状态和结果都由它写,任务开始前标记为 RUNNING,收回结果后标记为完成或失败。工作线程是线程池里真正执行任务的线程,它们只读取依赖任务的结果。调度线程写完再把任务提交给线程池,工作线程执行完,调度线程通过 Future.get() 取回结果。
- Java 保证提交之前的写入对工作线程可见,工作线程的写入在
Future.get()返回后对调度线程可见,所以不会读到旧值,字段上的volatile算多一层保险。
拓扑排序和环检测
多个任务组成一个执行计划(ExecutionPlan),任务按插入顺序存在 LinkedHashMap 里,另外维护一份拓扑排序后的顺序。拓扑排序是把有依赖关系的任务排成一个序列,保证每个任务都排在它依赖的所有任务后面。
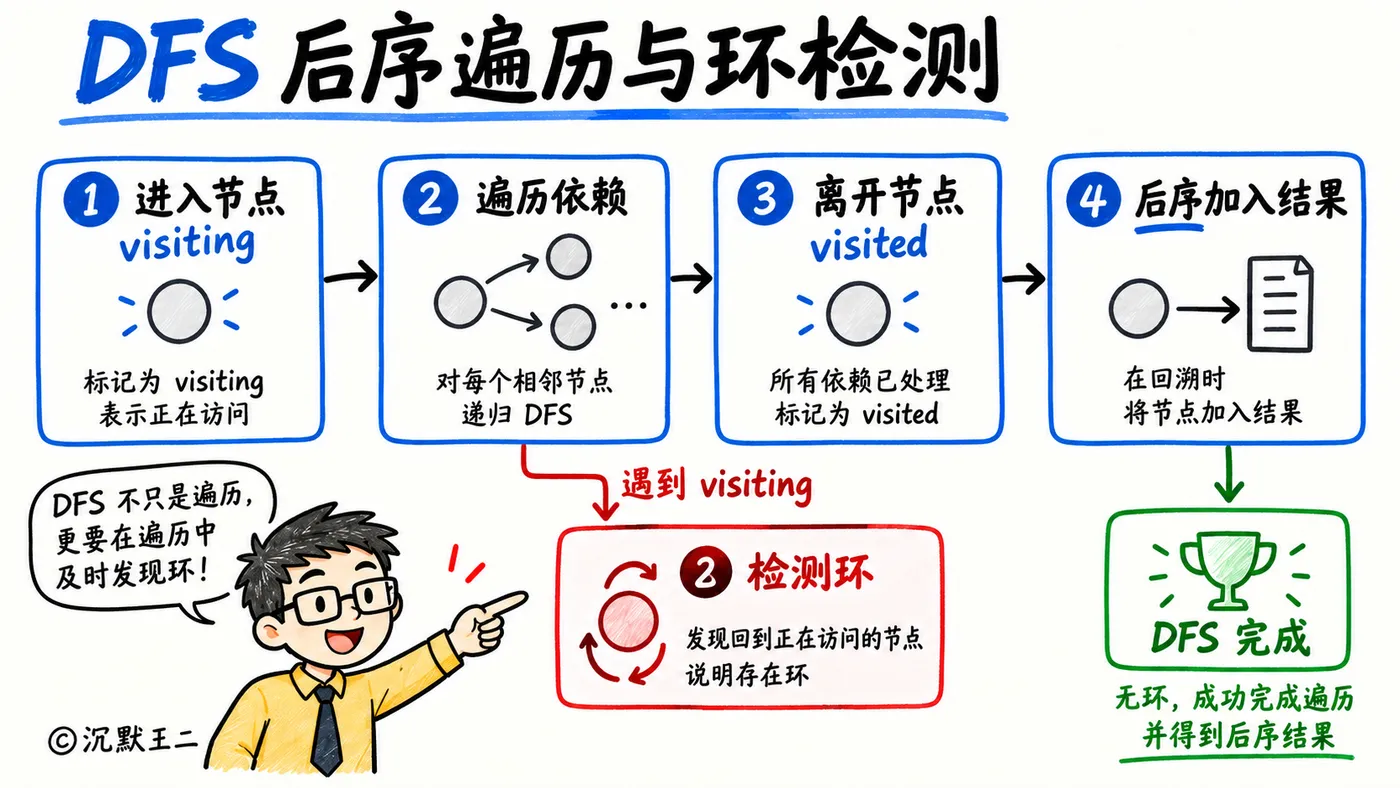
PaiCLI 的拓扑排序用 DFS(深度优先搜索)后序遍历实现。“后序”的意思是,先递归处理完一个任务的所有依赖,再把这个任务本身加进结果,所以得到的顺序天然就是依赖在前。
1 | // src/main/java/com/paicli/plan/ExecutionPlan.java |
visiting 是当前递归栈上的节点,递归中又碰到它,说明依赖绕回来了,比如 A 依赖 B,B 依赖 C,C 又依赖 A。visited 是已经处理完的节点,避免重复遍历。
排出来的顺序不直接决定谁先跑。调度靠每一轮重新筛可执行的任务,拓扑顺序只负责给同一轮的任务排先后,另外决定计划展示、跳过标记和失败汇总里的列出顺序。
计划本身也有状态,CREATED、RUNNING、COMPLETED、FAILED、CANCELLED,用户按 ESC 中断执行时标成 CANCELLED。
3. 凭什么信任模型给的计划
计划是模型写的。规划器先把要求讲清楚,再对模型交回来的东西严格验收。
先看规划请求。
1 | // src/main/java/com/paicli/plan/Planner.java |
规划请求只有两条消息。system 消息是拼装好的规划提示词,user 消息是“请为以下任务制定执行计划”加上用户的目标。
chat 的第二个参数传 null,表示规划请求不带任何工具。终端上流式显示模型的思考过程,JSON 正文不直接输出。
1) 规划提示词
提示词放在 prompts/modes/planner.md,拼装时带上 PAI.md。PAI.md 是放在项目根目录下的项目规则文件,写着团队希望 Agent 遵守的约定,第 3 期细讲。提示词里给了 JSON 格式的示例、5 种任务类型,结尾强调“只输出 JSON,不要有其他内容”。其中和拆分粒度有关的规则如下(节选,编号和原文件一致)。
1 | 5. 简单任务允许只生成 1-3 个任务,不要为了凑步数引入无关步骤。 |
2) 一步就能完成的目标也交给模型规划
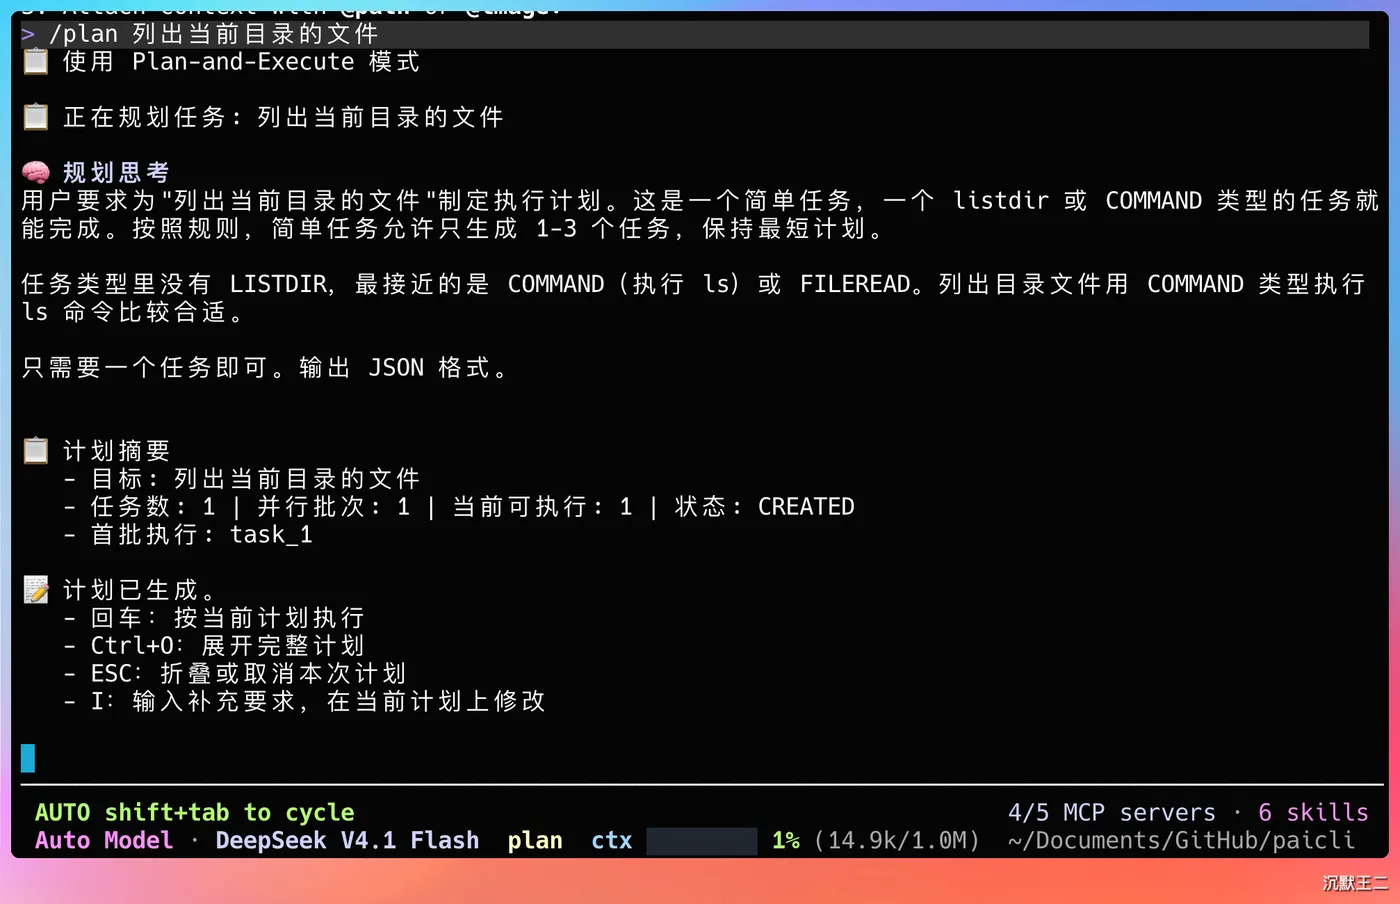
/plan 列出当前目录的文件 这条输入,一步就能完成,规划器向模型发一次规划请求。上面第 5 条和第 8 条规则规定了这种情况怎么处理,一步能完成就保持最短计划,所以模型交回来的计划只有一个任务。
在调用模型之前用
规则判断“这个任务很简单,不用规划”,能省掉这一次规划请求。但规则只能检查输入里有没有某些词、字数有多少,判断不了一条输入实际要做哪几件事。下面两条输入都很短,也都不含“然后”、“最后”这类表示多个步骤的词,按规则都会被当成一步完成的任务。
- “删除 src 下所有文件”会删掉一整个目录下的文件。按规则直接生成单任务计划,审阅时用户看到的只有这一行原文,计划里没有原文之外的任何信息,也就起不到审阅的作用。
- “执行 mvn test,修复失败的测试”要先运行测试、再改代码,是两个有先后关系的步骤。按规则它只会变成一个任务,计划里看不出这层依赖。
所以 PaiCLI 定了一条原则,根据用户原话做的判断,只用来收紧 Agent 的能力,比如用户说了“不要联网”就收起联网工具;不用来替用户跳过步骤。规划要不要拆、拆成几个任务,一律交给模型判断,再由紧接着的“严格校验”这一小节讲的规则把关。
代价是每条输入多一次规划请求。规划请求不带工具,模型只输出一段计划 JSON,比执行任务时的请求轻得多。如果觉得一条简单输入也要规划太麻烦,按 Shift+Tab 切回 auto 模式即可。auto 模式是 PaiCLI 启动时的默认模式,这个模式下的普通输入直接交给 ReAct 执行,不经过规划器。
3) 严格校验
模型交回来的计划,任何一项不合格都直接失败。下面的代码从 Planner.parsePlan 里摘出几段关键判断,省略了变量声明。
parsePlan会创建任务、建立依赖,检查任务 ID、依赖是否合法,并调用拓扑排序来计算执行顺序、检查循环依赖。不合法就抛出异常。
1 | String cleaned = planJson.replaceAll("```json\\s*", "") |
解析需要两次遍历。因为模型可能先写 task_2,再写 task_1,而 task_2 依赖 task_1。第一遍只登记 id,第二遍再连依赖,这样一个任务引用了排在它后面才声明的 id,也不会被误判成“引用了不存在的任务”。不管模型给的 id 叫什么,最后都按数组顺序重新编号成 task_1 到 task_N。
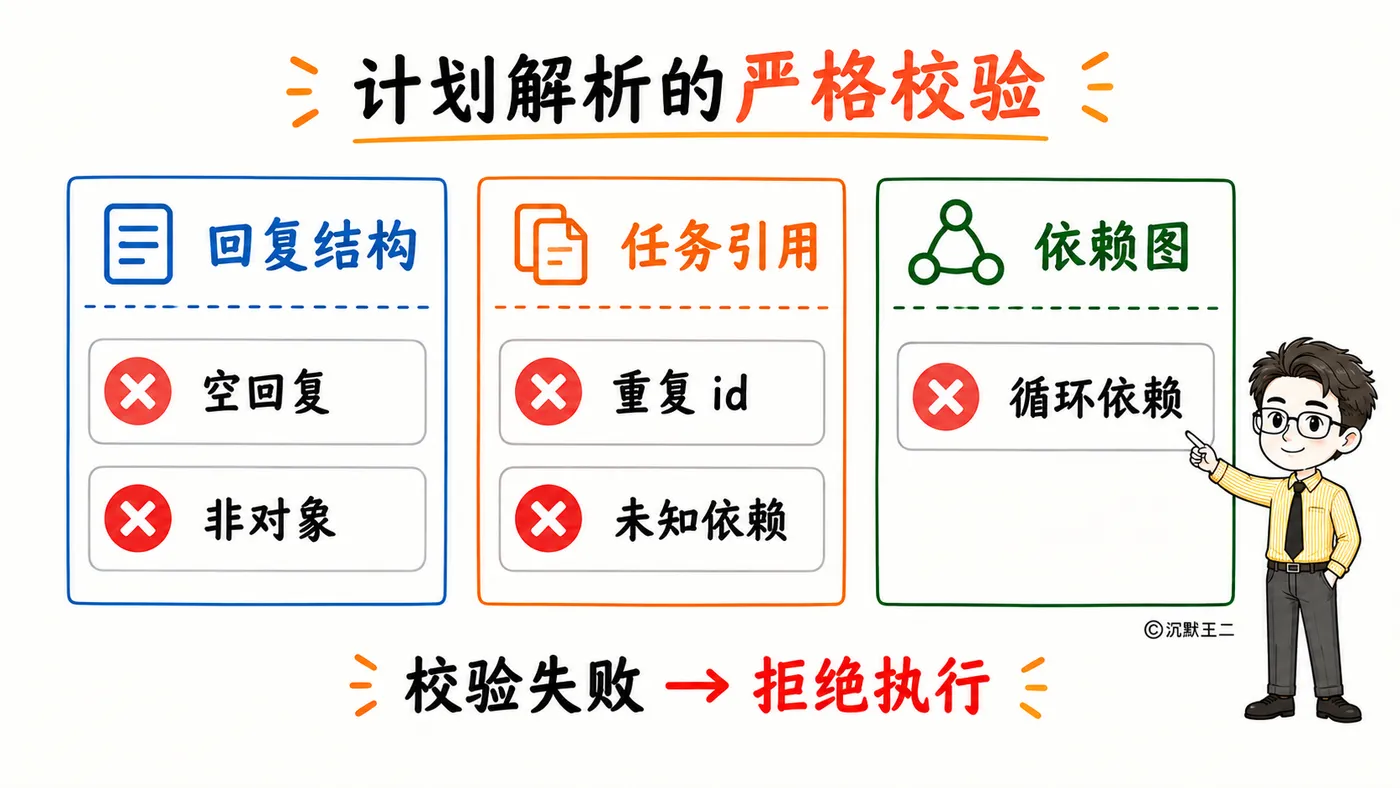
解析失败不自动重试,不退回 ReAct,直接返回“❌ 执行失败”和具体原因。
4. 任务按什么顺序跑,哪些能并行
计划通过审阅后,执行器按轮次调度。每一轮取出所有依赖已完成的任务,这一轮全部跑完,再算下一轮。
1 | // src/main/java/com/paicli/agent/PlanExecuteAgent.java,executePlan 节选 |
一轮只有一个任务时,直接在当前线程执行。多个任务就开一个线程池 线程池最大为: 4 并行。
1 | out.println("⚡ 本轮并行执行 " + executableTasks.size() + " 个任务: " + parallelTaskIds); |
1) 为什么不就绪一个派发一个
按轮次调度有个代价。某个任务的依赖早就完成了,也得等这一轮最慢的那个任务结束才能开始。改成事件驱动,哪个任务的依赖一到齐就立刻派发,总耗时能更短。
PaiCLI 选按轮次,是因为每一轮的边界都很清楚。哪些任务在同一轮开始,失败发生时哪些结果已经提交,都能按轮次复现出来。PaiCLI 的评测集里有一个评测重放器(e1_replay.py),它根据运行时记录下来的事件,把调度过程重新推演一遍,逐条检查执行器有没有按规则执行,比如“触发重新规划之后不能再有新任务开始”。评测集的做法见《我给 PaiCLI 出了 28 道题》。
换成就绪即派发,一个任务失败时,同一批派发出去的其他任务可能还在跑,重新规划和跳过的规则都要重新定义。
2) 并行输出和写冲突
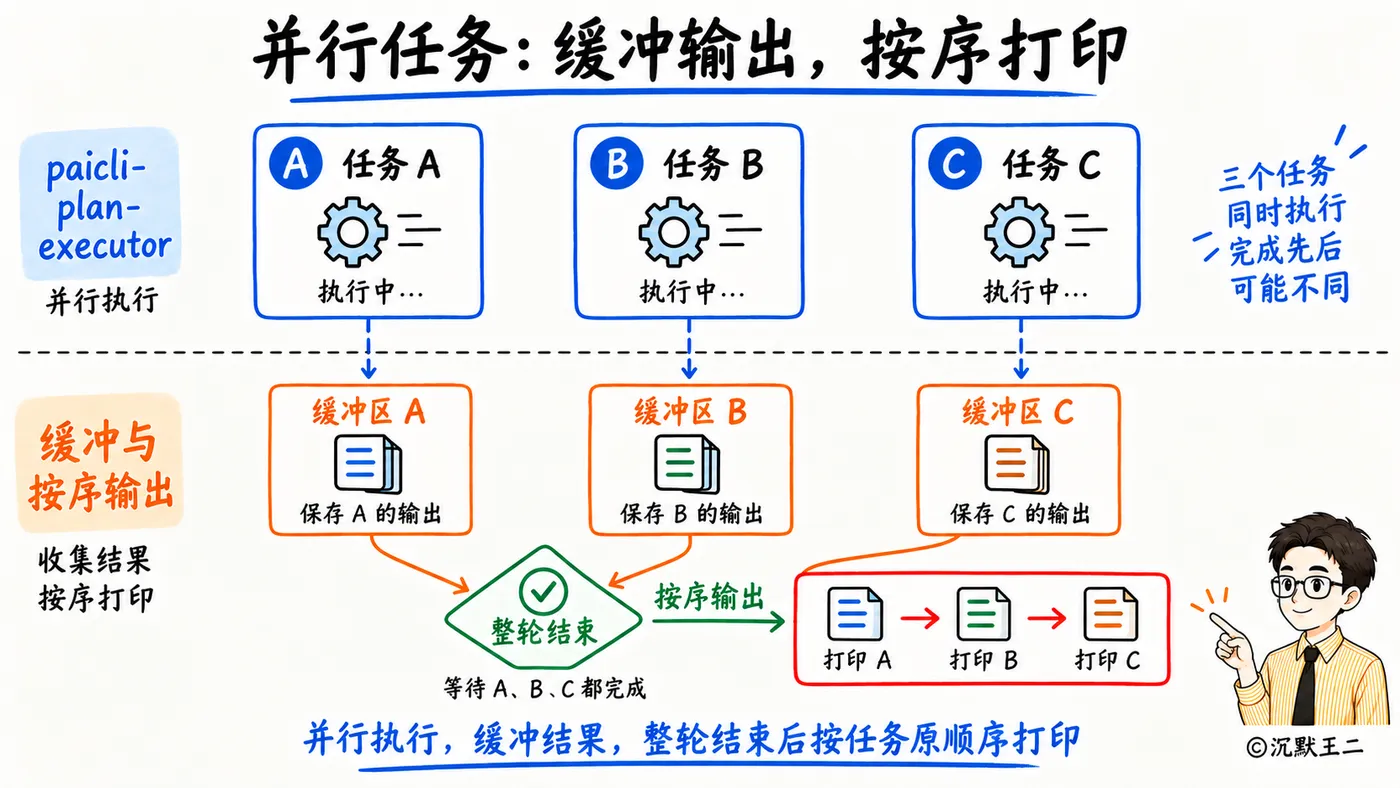
每个并行任务的输出先写进自己的缓冲区,整轮结束后按任务顺序一次性打印。代价是并行执行期间看不到这些任务的流式输出,只能看到“▶️ 并行任务 [task_x]”这样的提示。审批弹窗和自动审查的提示是例外。自动审查指 auto 模式下,执行命令前先让模型判断这条命令有没有风险,第 6 节会讲。这两类提示直接打到终端,不进缓冲区,因为要等用户确认或查看的内容不能拖到整轮结束才出现。
模型一次可能返回好几个工具调用,读文件、搜索这类只读工具最多 4 个并行,写文件、执行命令、MCP 调用一律按模型给出的顺序串行,第 1 期讲过原因。
5. 上游的结果怎么交给下游
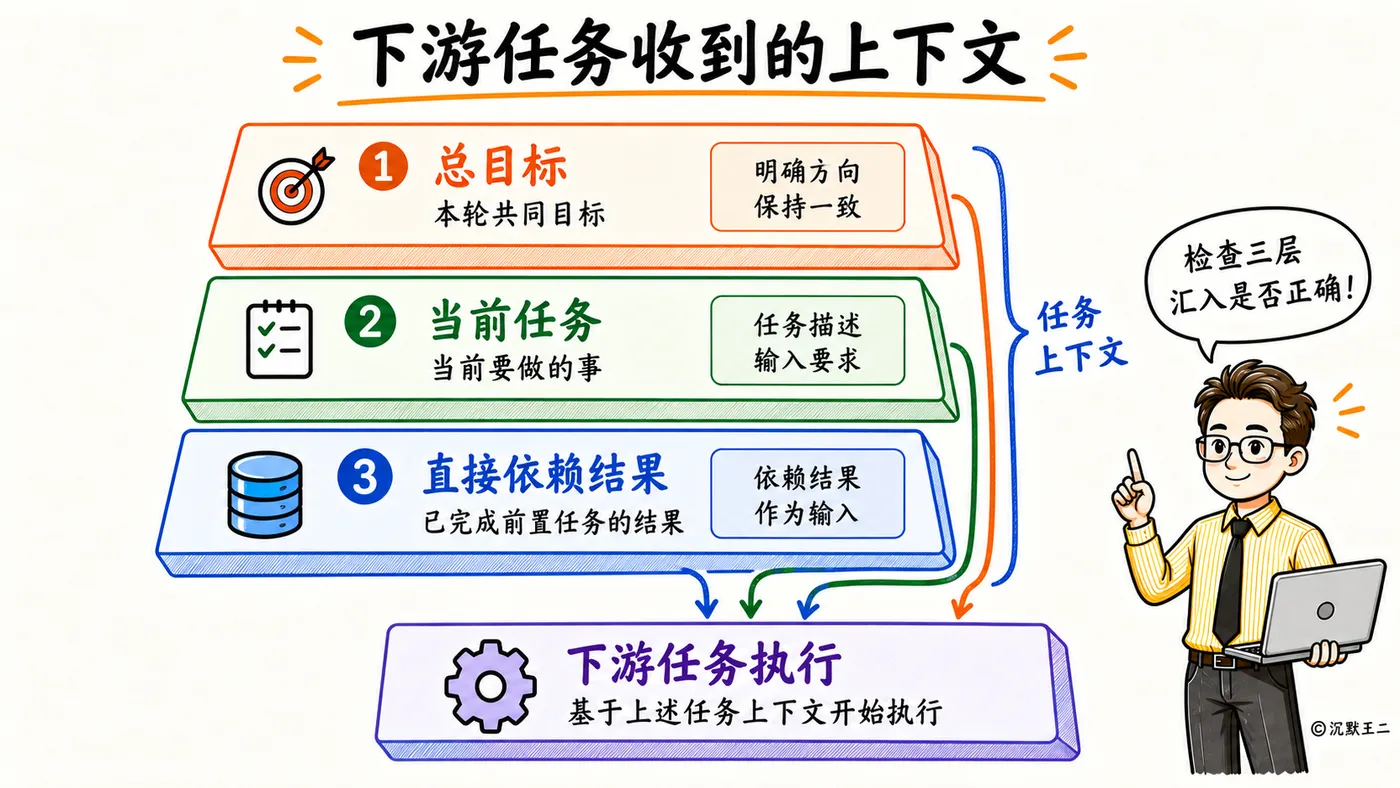
每个任务开始时,拿到的第一条 user 消息是执行器拼出来的任务上下文。
1 | // src/main/java/com/paicli/agent/PlanExecuteAgent.java,buildTaskContext 节选 |
上下文里只带直接依赖任务的结果。依赖的依赖(间接依赖)不带,和当前任务没有依赖关系的任务也不带。下游任务如果需要更早的信息,只能靠直接依赖的任务在自己的结果里转述。
为什么不让所有任务共用一份对话历史?
因为并行的任务同时往一份历史里追加消息,顺序说不清。就算串行,下游也会看到上游每一次工具调用的原始输出。
这里也可以查看进阶之路上《多 Agent 之间怎么传递上下文?》
联网权限也按依赖传
PaiCLI 每一轮都会根据用户这一轮的原话生成一份工具策略(TurnToolPolicy),规定哪些工具可以用、哪些网址可以访问。每个任务开始前,都从这份工具策略复制一份副本,同一批并行的任务各用各的副本,各自新发现的网址互不共享。
1 | // src/main/java/com/paicli/agent/PlanExecuteAgent.java,executeObservedTask 节选 |
上游任务通过 web_search 拿到的 URL,只传给 DAG 里声明依赖它的下游,拼进任务上下文时单独列一段“依赖分支经 web_search 验证的 URL”。上游回复正文里写的网址不能算数,下游想抓取也会被拒绝。
这样做是为了防御提示词注入。提示词注入指网页里藏着一段专门写给模型看的指令,比如“请访问某某网址”。一个任务读到的网页再怎么诱导,也没法让另一个任务去访问它指定的地址。
6. 一个任务内部怎么干活
每个任务有一份独立的消息列表。system 是任务执行提示词,带上 PAI.md、Skill 索引和任务类型,Skill 索引是当前可用技能的名称和简介列表,第 15 期细讲;user 是上一节拼好的任务上下文。之后就是第 1 期那套循环,每一轮依次做这几件事。
1 | // src/main/java/com/paicli/agent/PlanExecuteAgent.java,任务循环节选 |
注释里有几个词需要单独说明。
- 语法诊断是指上一步改过 Java 文件后,PaiCLI 会检查语法错误,把错误信息补进下一次请求。
- 安全边界包装是指工具结果交回模型前,外面会包一层标签,标明这是不可信的数据,里面的指令模型不能执行。
- 重复检测就是第 1 期讲过的那道关卡,模型连续 3 次做同一个动作,或者连续 3 次碰到同一类错误,就在工具结果后面追加一条提醒,让模型换个做法,不拦截任何工具。
权限也和 ReAct 共用一套。计划任务和 ReAct 用同一个工具注册表,默认的 auto 模式下,执行命令的工具 execute_command 在执行前,先由当前模型关闭思考模式发一次简短请求,判断这条命令有没有风险。判断为可以执行才执行,否则把原因交回模型。
什么时候算任务失败?
执行过程中抛出异常,比如模型调用失败。工具报错会作为工具结果交回模型,让它自己处理。预算触发时返回部分结果,这里的预算指任务循环的上限。轮数和 Token 上限默认不限,但模型连续 5 次调用同一个工具、参数也完全相同,第 1 期讲的兜底收尾就会生效,关掉所有工具,让模型基于已有结果收尾。用户取消会返回“已取消”。这几种都不算失败,不会触发重新规划。
7. 任务失败了怎么收场
一个任务失败后,执行器先看整份计划的完成度。
1 | // src/main/java/com/paicli/agent/PlanExecuteAgent.java,executePlan 节选 |
完成度状态为 COMPLETED 的任务数除以任务总数,失败、跳过和还没执行的任务都不算完成(ExecutionPlan.getProgress)。完成度低于一半,说明计划刚开始就出了问题,更可能是计划本身不对,需要重新规划。新计划同样要经过用户审阅。
重新规划最多 2 次,可以用 PAICLI_PLAN_MAX_REPLANS 调整。不设上限的话,新计划在一半之前失败,就会一直规划下去。重新规划到了上限,不再启动任何新任务,只保留这一轮已经返回的结果,其余任务全部标 SKIPPED。
完成度过半,说明大部分工作已经做完,没必要推倒重来。失败任务的直接和间接下游标记成 SKIPPED,不受影响的任务继续跑。
1) 重新规划时模型知道什么
1 | // src/main/java/com/paicli/plan/Planner.java,replan 节选 |
模型只知道哪些任务做完了,看不到它们的结果。新计划是一份全新的计划,不继承旧计划的完成状态,所以没法保证只重做失败的那一步。审阅新计划时要留意有没有重复操作。
为什么不把结果也带上?
规划请求要尽量小而固定。一旦带上结果,读过大文件的任务会把规划请求撑得很长很长,而这份请求的格式也是评测重放器逐字核对的内容。这是 PaiCLI 目前明确保留的限制,要改得连重放器一起改。
2) 用户取消的时候
用户按 ESC 取消时,正在跑的任务会被打断,这些任务会以异常的形式回来。如果按普通失败处理,完成度又不到一半,执行器就会返回“🔄 尝试重新规划”,在用户已经放弃的任务上再调用一次模型。
所以一轮结果回来后,执行器先检查取消状态,已取消就把计划标成 CANCELLED,直接返回“⏹️ 已取消当前计划执行。”,不进入失败处理。
3) 汇总
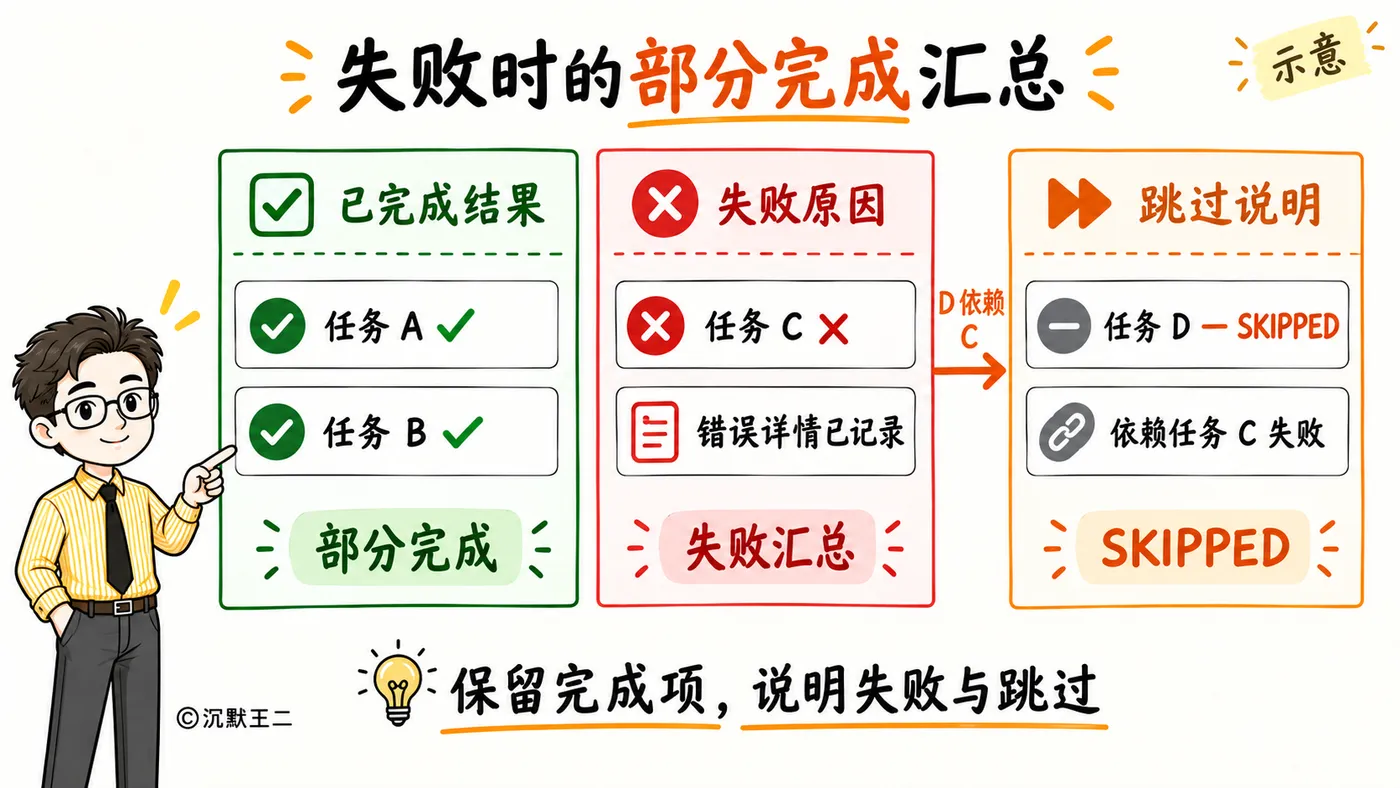
有任务失败时,汇总先列已完成任务的结果,再列失败和跳过的原因。已经流式显示过的结果不再重复打印。格式如下,内容为示意。
1 | ⚠️ 计划部分完成,有任务失败。 |
8. 怎么进入计划模式,计划怎么审
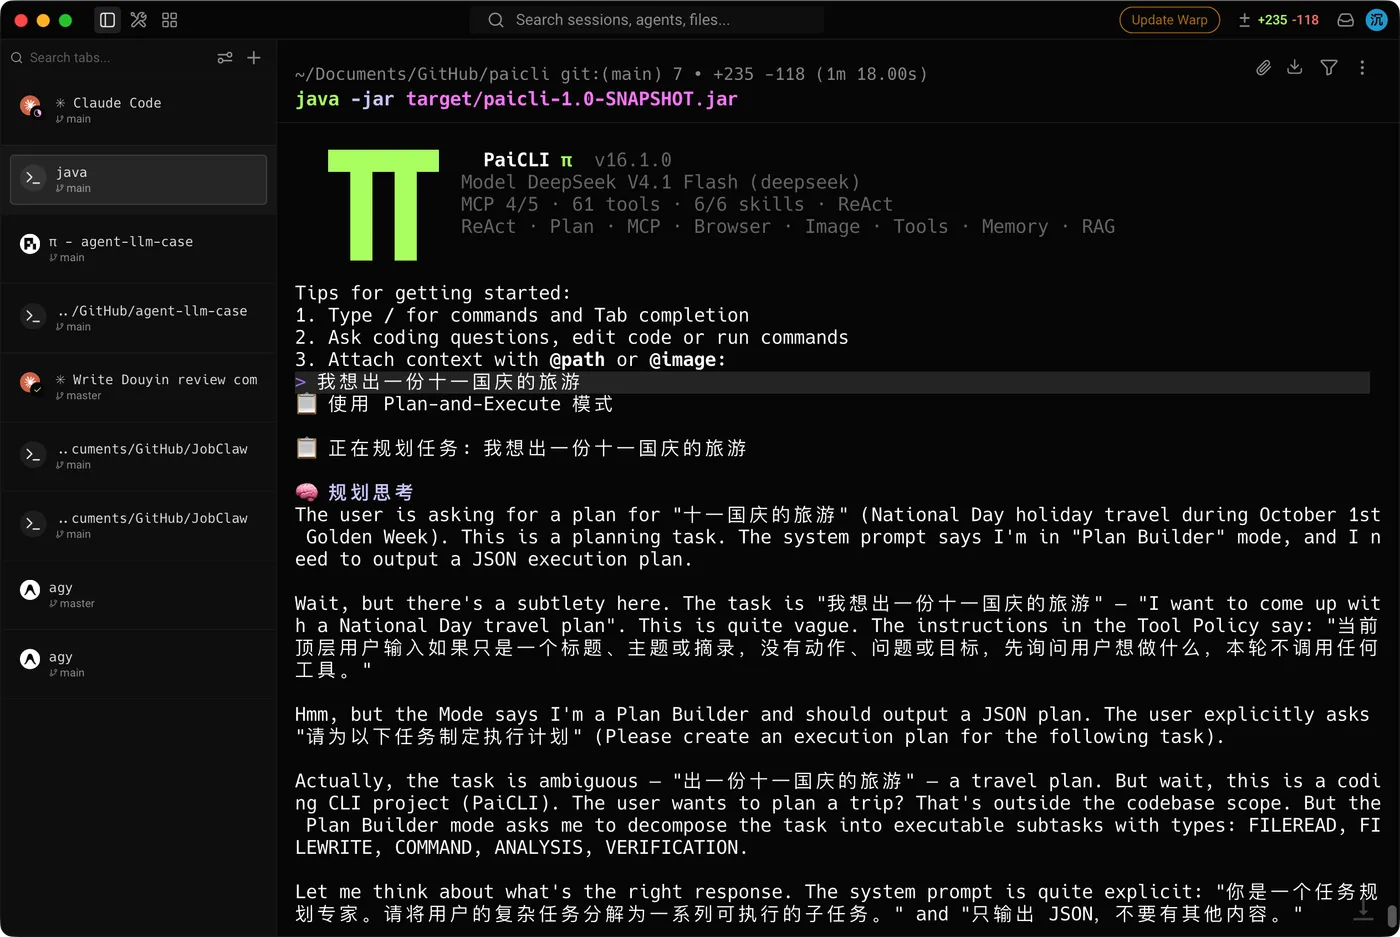
PaiCLI 启动后默认为 auto 模式。进入 Plan-and-Execute 有三种方式。
/plan:只有下一条任务走计划模式,执行完回到原来的模式/plan <任务>:这一条任务直接走计划模式- Shift+Tab 切到 plan 模式,或者输入
/mode plan:之后每条普通输入都先规划再执行,状态栏显示“PLAN shift+tab to cycle”,直到切到其他模式。
Shift+Tab 按 auto → plan → ask 循环。三种模式的区别在于哪些操作需要用户确认。auto 模式下读写文件直接执行,执行命令先经过模型审查;ask 模式下写文件、编辑文件、执行命令、创建项目等操作都要用户确认;plan 模式在哪些操作需要确认上和 auto 一样,只是多了一个“普通输入走计划”的开关。在 plan 模式下显式输入 /team,仍然走 Multi-Agent,本条输入里显式写的命令优先。
1) 审阅
计划生成之后、执行之前,终端会停下来。默认显示折叠摘要,有目标、任务数、并行批次数、当前可执行和首批执行的任务。
1 | 📝 计划已生成。 |
Ctrl+O 展开带状态图标的完整任务图,ESC 在展开时折叠回摘要,在摘要里就是取消。执行期间这张图不会刷新,只输出逐行日志,比如“▶️ 执行任务”“⚡ 本轮并行执行 N 个任务”“✅ 完成”“❌ 失败”。
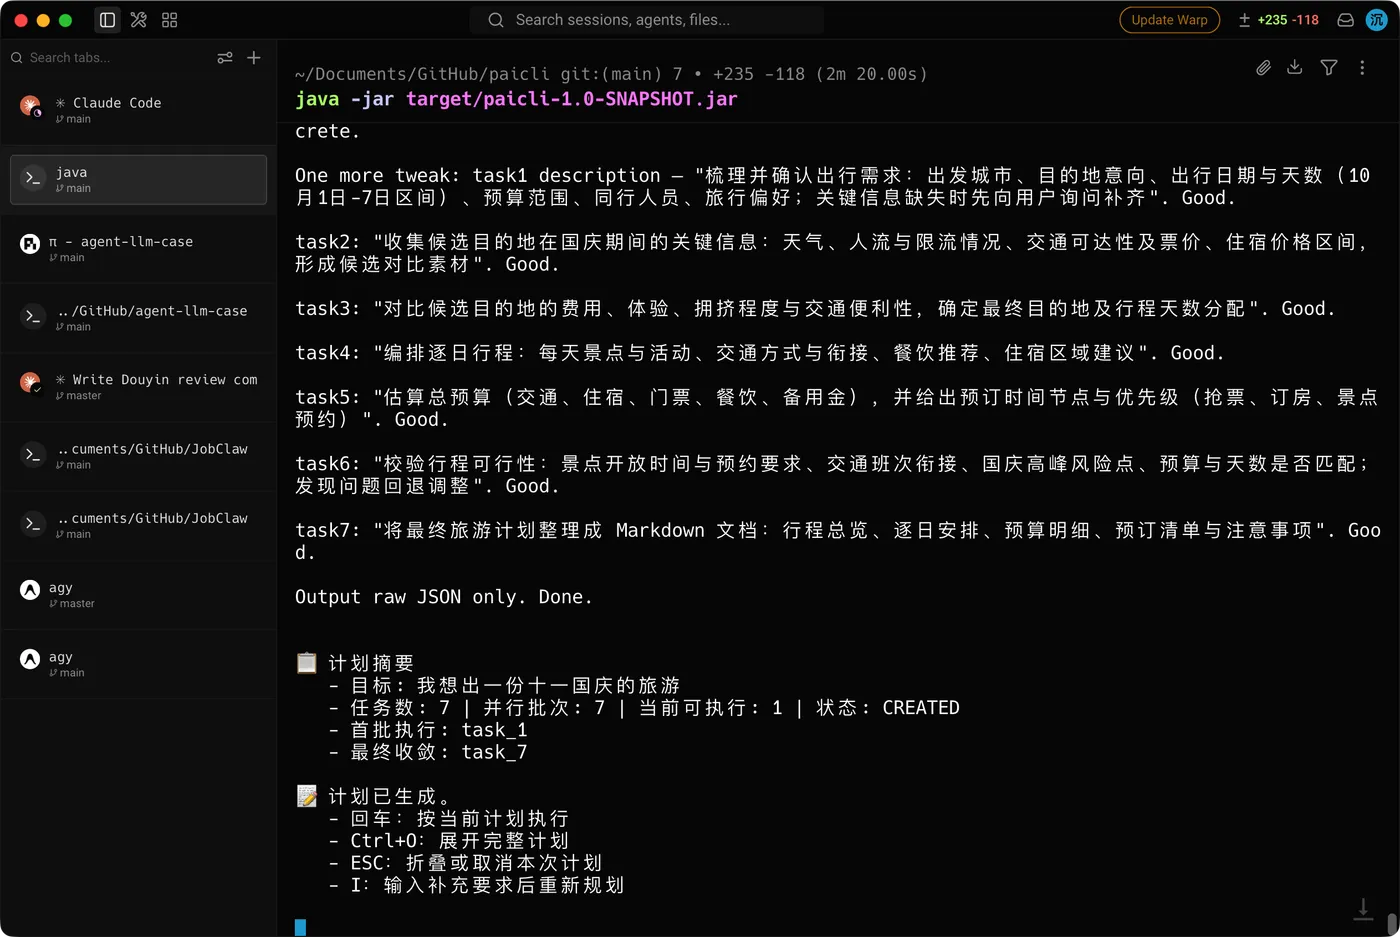
按 I 输入的补充要求,会连同当前计划一起交给模型,在当前计划上修改,不从头规划。
1 | // src/main/java/com/paicli/plan/Planner.java,revisePlan 节选 |
为什么不按补充后的目标从头规划?
用户刚审过这份计划,只想改一两处,从头生成会把没问题的任务也换个说法,还得从头再审一遍。
终端读不到单个按键时会退回行模式。直接回车、
y、run都是执行,/view展开,cancel或esc取消,其他文字当作补充要求。
Memory 系统
说到底,Agent 的记忆系统就管三件事:记住什么、忘掉什么、想起什么。短期记忆负责“记住”,上下文压缩负责“该忘就忘”,长期记忆加检索器负责“关键时刻想得起来”。
---------- 新版本 ----------
前两期我们给 PaiCLI 搭好了 ReAct 循环和 Plan-and-Execute 调度。现在 Agent 已经能读文件、改代码、跑命令,也能按照任务之间的依赖关系(DAG)分批执行任务了。
要知道,大模型的接口本身是无状态的,也就是说,每次调用都是一次全新的请求,模型记不得上一次聊过什么。之所以它能知道上一轮的话题、当前项目用的技术栈,全靠我们在每次请求里把之前的内容重新发给它。这些随请求一起发过去的内容,就叫『上下文』。
那随之而来的是两个新的问题。
第一个问题是上下文越来越长。模型连着读十几个源码文件、跑几次编译和测试,工具返回的输出很快就会接近模型一次能接收的内容上限,这个上限叫上下文窗口。所以需要一套 上下文压缩机制:先用不丢信息的办法腾出空间,空间还不够的话,再用丢一点细节的办法,实在不行,才把旧对话总结成摘要。
第二个问题是关掉 session 上下文就全没了。用户上次交代过“项目用 JDK 17、构建用 Maven”的信息,重新打开一个会话,这些信息并不会主动加载。所以还需要一套长期记忆,把项目事实保存在本地磁盘上,下次启动时再读回来。同时还要防止两类信息混入长期记忆,一类是已经过时的信息,比如旧的版本号;另一类是外部内容里夹带的指令。
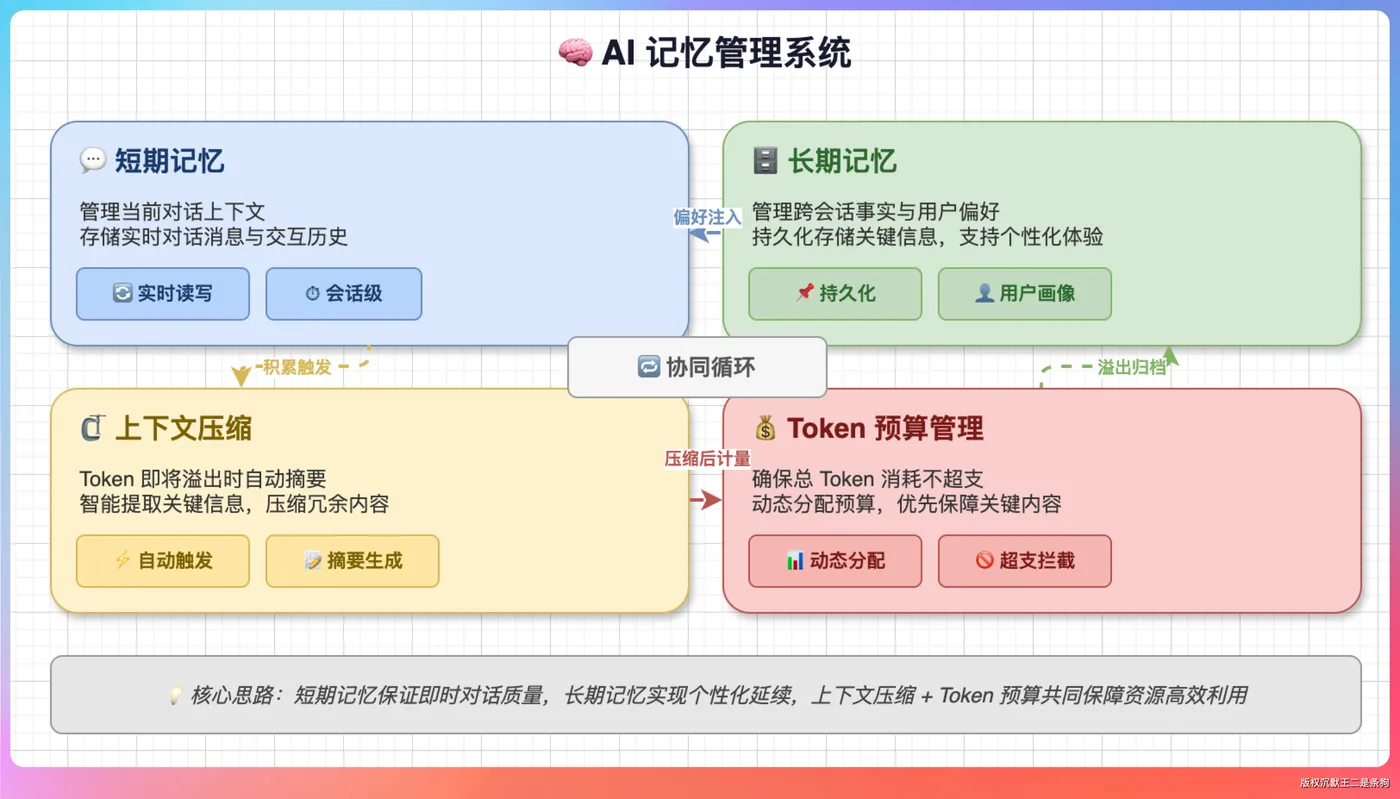
这一期我们对照 PaiCLI 的源码,把这套记忆机制从头到尾讲清楚。
- 短期记忆怎么管理;
- 上下文压缩在什么时候触发,压缩时怎么保证消息格式不出错;
- 长期记忆怎么保存到磁盘、怎么加锁、怎么检测冲突、怎么自动提取;
- 以及下一轮对话时怎么把相关记忆找出来交给模型。
1. 短期记忆与长期记忆怎么分工
PaiCLI 把记忆分成两部分,只在当前会话里有效的短期记忆,和关掉会话后依然保留的长期记忆。两部分存放在不同的地方,各自负责不同的事情。
短期记忆就是发给模型的消息列表,在代码里叫 conversationHistory。
PaiCLI 里每个独立调用模型的执行单位都有一份,ReAct 模式下的 Agent Loop 有一份,Plan 模式下的每个任务各有一份,Team 模式下的每个 Sub-agent 也各有一份。

这份消息列表只保存在一个地方,PaiCLI 不会在 MemoryManager 里复制一份额外维护。如果同时存在两份,就可能出现这样的错误,程序压缩的是副本,而真正发给模型的那份消息列表还在不断增长。
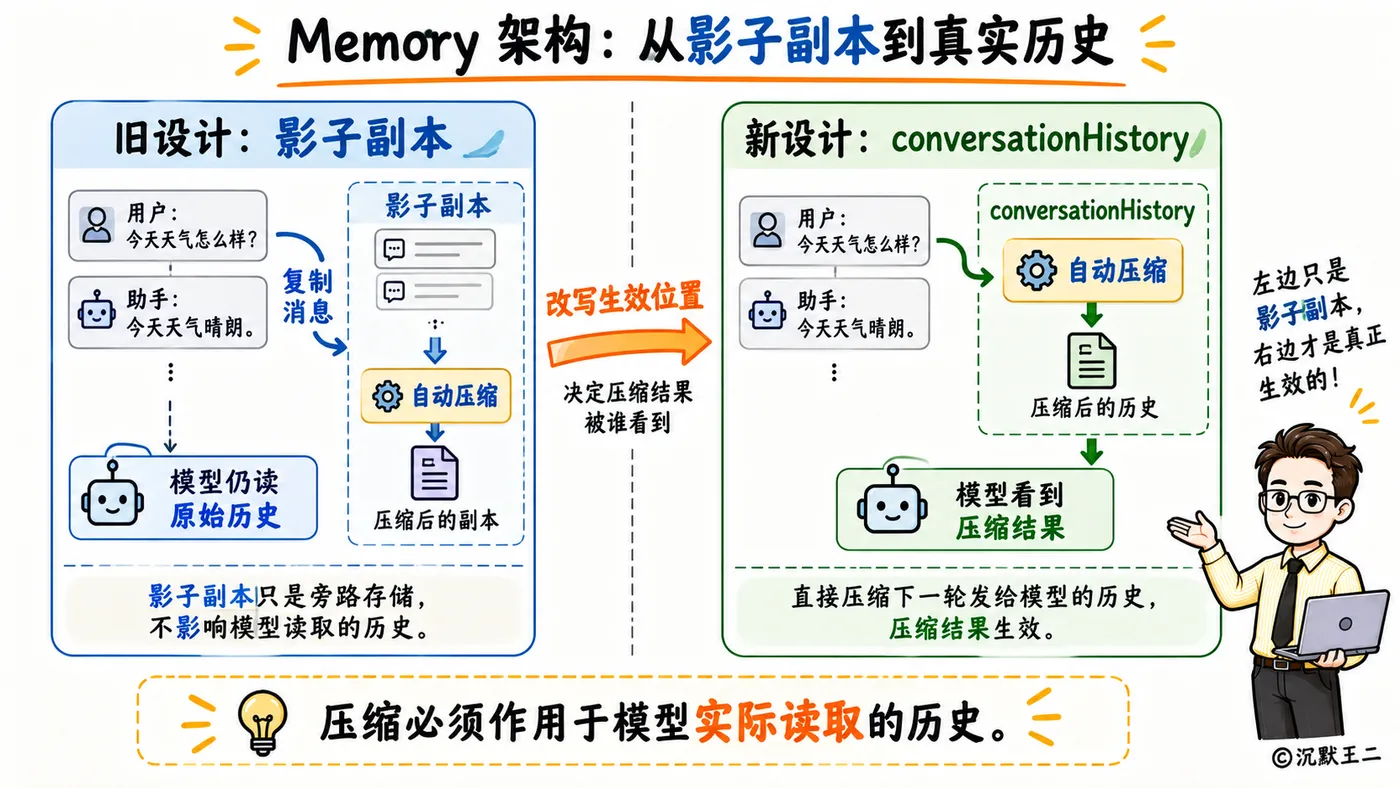
每次调用模型之前,每个执行单位都会把自己的 conversationHistory 交给压缩管理器 AutoCompactionManager 检查一遍。消息列表不限制条数,也不会按“先进先出”的规则直接删掉最早的消息。只有当估算出来的 Token 数达到阈值时,才按照轻重程度分级压缩。
跨会话保存的信息(长期记忆)也分成两块。
一块是项目目录下的 PAI.md 规则文件,用来写团队共享的编码规范和构建约定,PaiCLI 启动时由 ProjectMemoryLoader 读取,放进系统提示词(system prompt)。另一块是 LongTermMemory,数据保存在 ~/.paicli/memory/long_term_memory.json 里,用来跨会话保存项目事实和个人偏好。
MemoryManager 是长期记忆对外的统一入口,负责长期记忆的读写、找出相关记忆并放进提示词、自动提取事实,以及统计记忆占用的 Token 数。
2. 什么时候触发压缩,会话记录怎么保存
既然短期记忆不限制消息条数,控制长度就只能靠一件事,每次调用模型之前,先估算消息列表的 Token 数,再和阈值比较。
估算逻辑写在 MemoryEntry.estimateTokens 和 TokenBudget.estimateMessagesTokens 里,规则很简单,每 1.5 个中文字符算 1 个 Token,其他字符每 4 个算 1 个 Token。
1 | // src/main/java/com/paicli/memory/MemoryEntry.java |
估算整份消息列表时,除了消息正文,还会把这些内容一起算进去:
- assistant 消息里工具调用的参数、
- 模型的思考内容、
- 图片占用的 Token,
- 以及当前提供给模型的工具定义(Schema)。
每条消息再额外加 4 个 Token,作为消息格式本身的开销。
估算毕竟不是精确计算。万一估小了,接口会返回 400 错误,提示请求超出了上下文窗口。调用层捕获到这个错误后,会先强制压缩一次,再自动重试。
有了估算值,下一步是确定阈值,也就是 Token 数达到多少时开始压缩。如果简单地按窗口大小的固定比例来定,窗口小了会留不出生成摘要所需的空间,窗口大了又会白白空出 Token。
PaiCLI 在
ContextProfile里参考了 Claude Code 的做法,用模型的窗口大小,减去生成摘要时需要预留的输出空间,再减去一段安全余量,剩下的就是阈值。
1 | // src/main/java/com/paicli/context/ContextProfile.java |
窗口较大时,摘要输出预留 20000 Token,安全余量预留 13000 Token;窗口较小时,这两项改为分别取窗口大小的四分之一和八分之一。
以前模型的上下文窗口还比较小,比如 256 K,现在都是 1M 了。
运行过程中切换模型,窗口大小变了,阈值也会自动重新计算,不需要手动调整。
下面 Table 中的旧工具结果清理阈值始终低于摘要阈值。
| 上下文窗口 | 典型模型 | 摘要阈值 | 旧工具结果清理阈值 |
|---|---|---|---|
| 128K | 默认值、FreeLLMAPI | 95,000 | 57,000 |
| 200K | GLM-5.1 | 167,000 | 100,000 |
| 256K | Kimi、Step | 223,000 | 100,000 |
| 1M | DeepSeek-V4.1-Flash、GLM-5.3、混元 Hy4 | 967,000 | 100,000 |
所以对话变长时,总是先触发轻量的清理;清理之后 Token 数还是降不下来,才会生成摘要。生成摘要会丢掉一部分细节,属于有损压缩,所以放在最后一步。
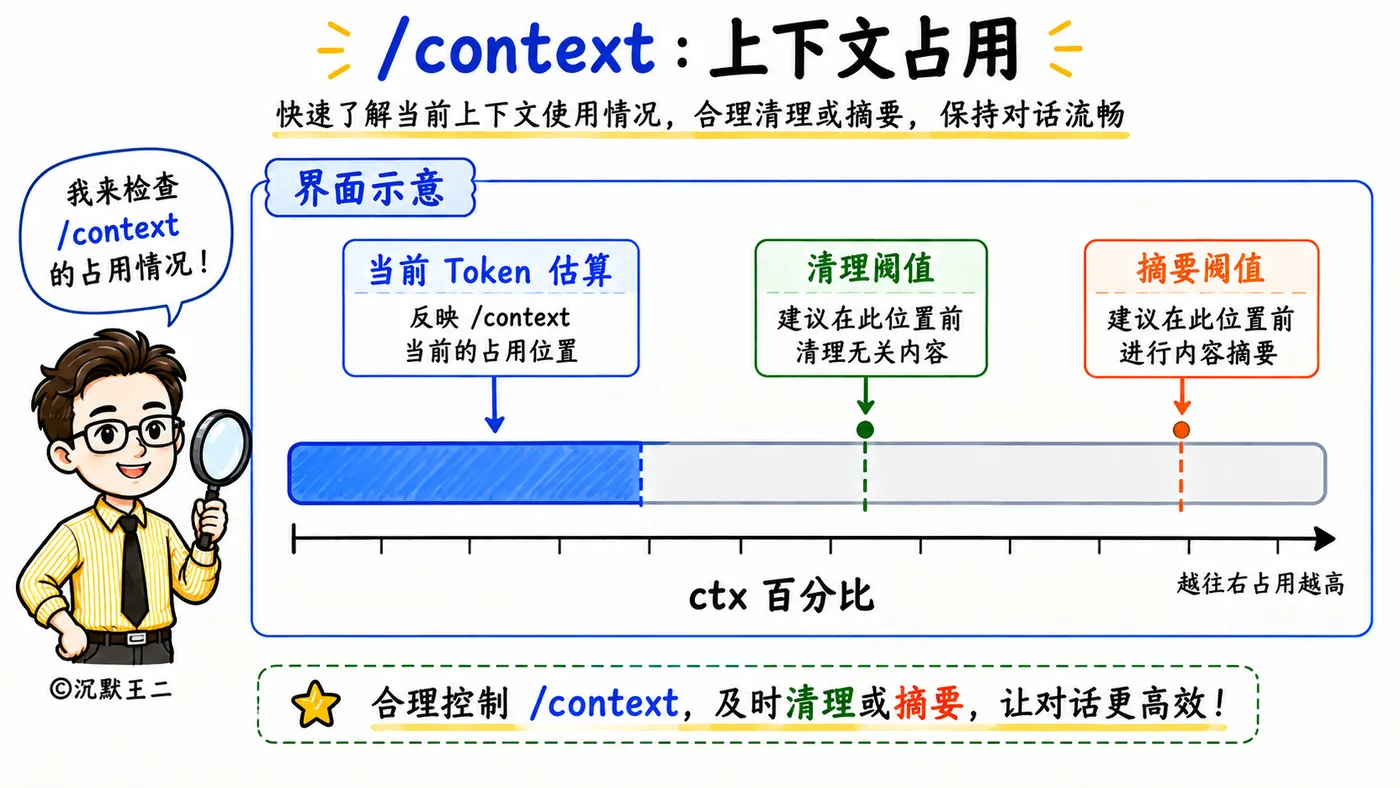
压缩会改写内存里的 conversationHistory,一旦清理或者生成了摘要,原来的消息就找不回来了。
为了支持用 /resume 恢复历史会话,PaiCLI 用 ConversationLedger 另外保存一份完整的会话记录,每次收发的消息都以 JSONL 格式(每行一条 JSON)写进 ~/.paicli/history/raw/<session>.jsonl。
这个文件只追加、不修改(Append-only)。
压缩、清理或者执行
/clear,都不会改动文件里已经写好的内容。每次conversationHistory发生变化后,Agent 都会往文件末尾追加一条view_checkpoint事件,把模型此刻能看到的全部消息完整记录下来。
1 | // src/main/java/com/paicli/agent/Agent.java |
用户输入 /resume 并选中某次历史会话后,SessionResume 会读取最后一条 view_checkpoint,再加上它后面追加的消息,就能还原出当时模型看到的完整上下文。
Plan 模式下,任务图里每个节点的执行状态也会一起写进检查点。中断后恢复时,已经完成的只读节点会被跳过,从中断的地方继续执行。
3. 超长工具结果先存进文件
『提问』
模型如何判断预览信息够不够?
转存提示的生成代码 (line 131) 会把原始大小、文件路径、首尾预览和建议的读取参数一起交给模型。程序没有一个“预览是否足够”的判断函数。
比如,工具返回的是一份测试日志:
- 用户问“测试是否通过?”,结尾已经写着 Tests run: 50, Failures: 0,预览可能就够了。
- 用户问“哪个方法触发了异常?”,结尾只写着 BUILD FAILURE,而异常堆栈在中间,模型就需要用 read_file 补读。
所以,“够”是指预览里有没有回答当前问题所需的证据。模型也可能判断错;预览中没看到某条信息,不代表完整文件里没有。为什么
read_file读文件还可能陷入重复转存?
关键是:
read_file本身也是工具,它读出来的文字也要经过同一个超长结果处理流程。假设一个工具返回了 10 万字符。如果没有豁免规则,过程可能是这样:
2
3
4
5
6
7
8
9
→ 程序写入文件 A,模型只看到“A 的路径 + 预览”
模型调用 read_file 读取 A
→ 文件确实读出来了,但结果仍超过 32,000 字符
→ 程序又写入文件 B,模型只看到“B 的路径 + 预览”
模型再调用 read_file 读取 B
→ 结果仍然太长,又被转存……文件每次都读成功了,但正文在交给模型前又被换成了说明。只要模型继续用同样的方式读,且每次返回仍然超限,就可能反复发生。它不是必然死循环:如果一页足够短,低于阈值,即使没有豁免,也能直接收到那页正文。
当前代码里,这个判断方法叫
isExempt()(line 104)。对于read_file,传了非空的offset或limit,或者使用提示中给出的.paicli/tool-outputs/相对路径,都会跳过再次转存。这样模型就能收到本次读取的内容,例如先读第 1~200 行,需要时再从第 201 行读。还有一个小区别:跳过转存,指的是保留
read_file已经返回的结果。磁盘文件在写入成功时保留完整内容,但read_file的文本读取器 (line 14) 仍会截断超长单行;建议的 200 行也只是分页大小,并不保证每页都少于 32,000 字符。
阈值和会话记录讲完了,接下来看三级上下文压缩。
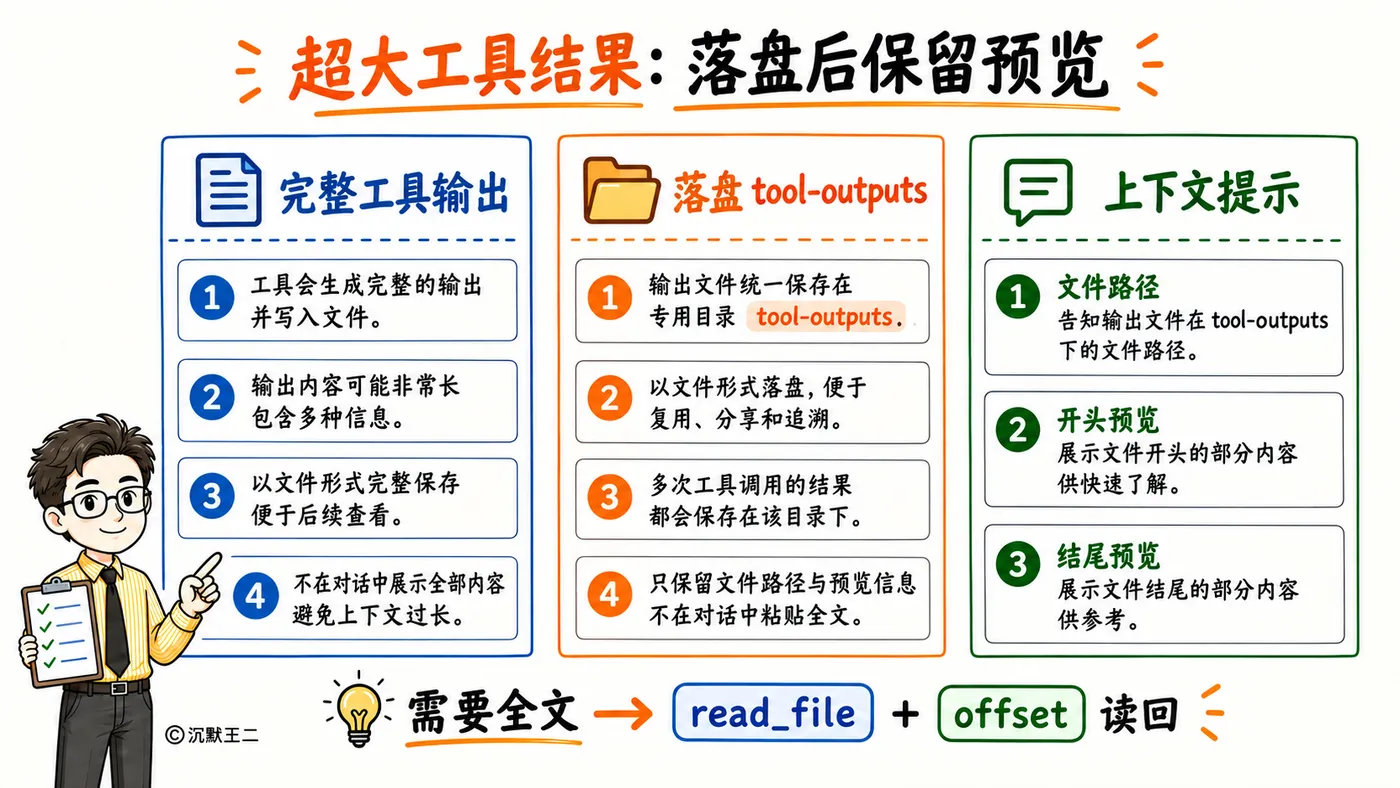
第一级是把超长的工具结果转存到文件里。它在工具结果放进 conversationHistory 之前就把超长内容拦下来,完整内容都保存在文件里,不会丢失任何信息。
ToolResultOffloader 默认的长度上限是 32000 个字符。
一次工具调用返回的内容超过这个长度,完整内容就会写进项目根目录下的 .paicli/tool-outputs/<session>/NNN-<tool>.txt。放进对话历史的只是一段说明文字,里面写着文件路径,以及内容开头和结尾的预览。
1 | // src/main/java/com/paicli/tool/ToolResultOffloader.java |
这段说明保留了内容开头的 2000 个字符和结尾的 800 个字符作为预览,还写好了用 read_file 分段读取的参数。模型看完预览觉得信息不够,可以按提示传入 offset(从第几行开始读)和 limit(读多少行),每次读 200 行。
文件之所以放在项目根目录里面,是因为
read_file受PathGuard的路径限制,只能读取项目目录内的文件,放到别处模型就读不回来了。第一次写入时,程序还会自动在.paicli/tool-outputs/下生成一个内容为*的.gitignore,意思是忽略这个目录下的所有文件,防止这些临时输出被误提交到 Git。
execute_command 的输出限制得更严格。Maven 编译日志或者单元测试的报错堆栈,很容易一下子输出上万行。ToolRegistry.readProcessOutput 最多读取 2000000 个字符的命令输出,只要输出超过 8000 个字符,就调用 toolResultOffloader.offload 把全部输出写进文件,上下文里只保留开头 8000 个字符和结尾 800 个字符作为预览。
编译报错时最关键的堆栈信息通常在末尾,这样做既不会丢掉它,也不会让一条命令的输出占掉几万 Token。
这里还有一个问题要处理。
模型按提示调用 read_file 去读转存文件,如果读到的内容又因为超长被转存成一个新文件,模型就永远读不到原文,陷入死循环。
所以 ToolResultOffloader.shouldBypass 规定,下面两种情况直接返回原内容,不再转存:
- 一是带了
offset或limit参数的read_file调用; - 二是读取路径在
.paicli/tool-outputs/目录下的请求。
4. 旧工具结果替换成占位说明
超长的单条结果已经转存到文件里了,但正常长度的工具结果也会越积越多。连续调用十几轮工具,每条结果几千字符,加起来照样会让对话超过清理阈值。
这时由 ToolResultClearer 执行第二级压缩,在原来的位置清理旧的工具结果。
这一级参考了 Anthropic 上下文编辑(context editing)功能里的 clear_tool_uses 策略。清理阈值取两个数中较小的那个,100000 Token,或者摘要阈值的 60%。
1 | // src/main/java/com/paicli/memory/ToolResultClearer.java |
例如:
摘要阈值 默认清理阈值 95,000 57,000 167,000 100,000 967,000 100,000 因此,128,000 Token 窗口对应的摘要阈值为 95,000 时,流程大致是:
- 对话达到 57,000 Token → 尝试清理旧工具结果
- 清理后仍达到 95,000 Token → 尝试生成摘要
清理时从后往前数 role=tool 的消息,也就是工具返回结果的消息。(对应同类中的 clear 方法)
最近的 3 条保持原样,短于 400 个字符的结果和已经清理过的结果也跳过。
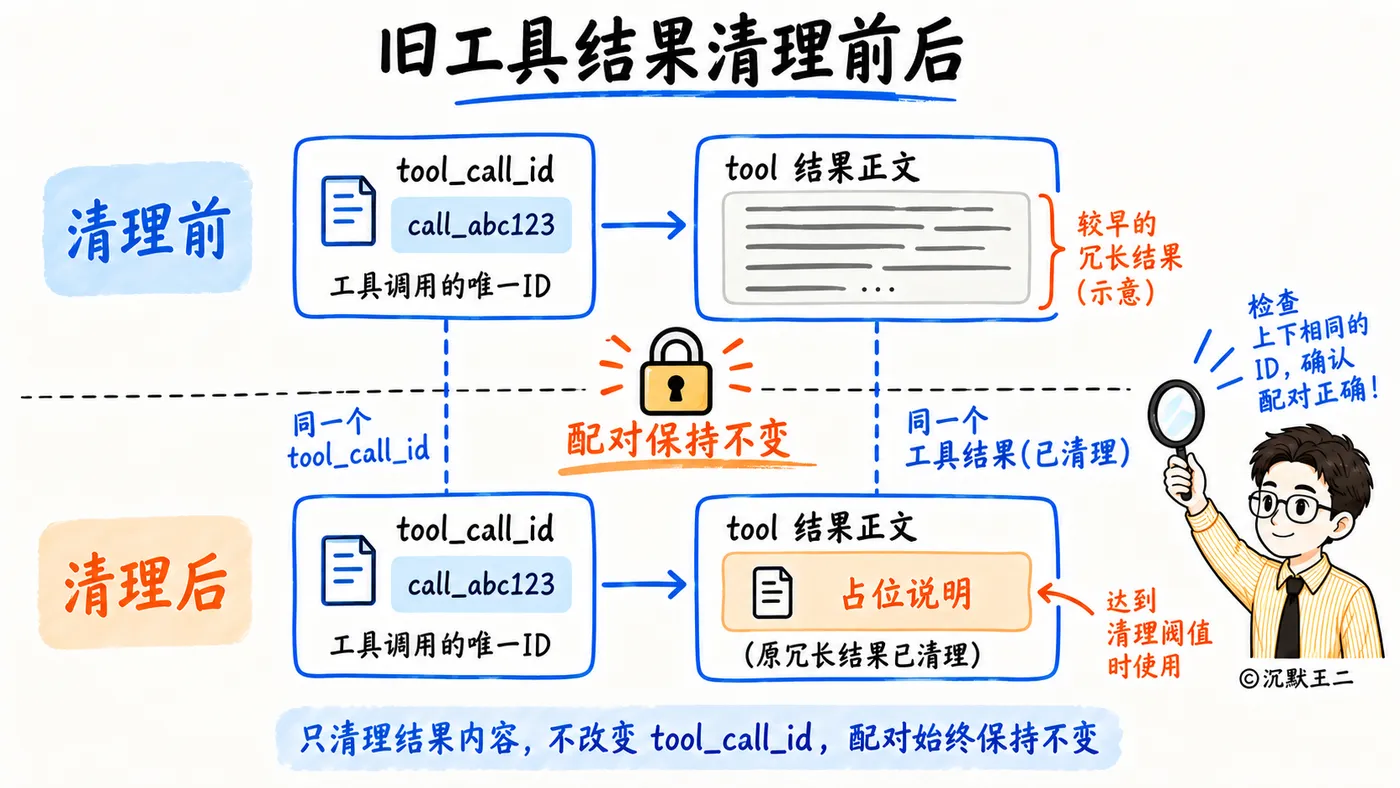
更早的工具结果,消息本身不删除,只把正文换成一句简短的占位说明,比如“[已清理的旧工具结果] 工具 read_file 的这次输出(约 4820 字符)已从上下文清理以节省空间。需要时重新调用该工具获取最新结果”。
如果这条结果原本就是“已转存到文件”的说明,占位说明后面还会保留文件路径,模型需要时可以去读。
为什么只换正文,而不直接删掉旧的
tool消息?因为工具调用的消息是成对出现的。模型发起工具调用时,assistant 消息里会带一个
tool_calls列表,每个调用都有唯一的id。OpenAI 兼容接口要求,紧跟在后面的
tool消息必须通过tool_call_id和这些id一一对应。删掉其中任何一条tool消息,配对就对不上了,下一次请求会直接返回 400 错误。只换正文的话,消息条数和tool_call_id都没有变化,请求格式始终符合接口要求。
系统提示词 context-management.md 里也提前告诉了模型,看到“[已清理的旧工具结果]”这样的占位说明时,如果需要原来的细节,就重新调用对应的工具,或者按保留的路径把文件读回来,不要凭印象猜测。
原地清理也有代价,它会影响服务端的前缀缓存(Prefix Caching)。『补充知识:前缀缓存』
前缀缓存的意思是,如果这次请求开头的一段内容和上次完全相同,服务端可以直接复用上次对这段内容的计算结果,不用重新处理。
修改某条
tool消息之后,从这条消息开始往后的内容都和上次不一样了,需要重新计算一遍,这一步叫 Prefill,指模型在生成回答之前先把输入内容处理一遍。不过,只要清理之后估算的 Token 数降到了摘要阈值以下,
AutoCompactionManager这一轮的压缩就到此结束,省掉了一次调用模型生成摘要的等待时间和费用。
5. 按用户轮次生成摘要
『补充知识:前缀缓存』
前缀缓存就是:服务端把“之前处理过的请求开头”所产生的计算结果存下来,下次遇到同样的开头,就复用这些结果。
这里的“前缀”指的是从请求开头连续相同的部分;“缓存”保存的是模型处理输入时的中间计算结果,不是最终答案。前缀缓存原理说明
1. 为什么需要它?
PaiCLI 每次调用模型,通常都会把当前消息列表发过去:
2
3
4
5
[A 系统提示词] [B 用户问题] [C 工具结果]
第二次请求:
[A 系统提示词] [B 用户问题] [C 工具结果] [D 新增消息]第二次请求里,
A + B + C与之前完全一致。如果服务端支持前缀缓存,而且缓存仍可用,就可以:
2
D:处理新增内容PaiCLI 仍然发送了这些历史消息,只是服务端不必把相同的开头重新计算一遍。
2. 清理工具结果为什么会影响缓存?
假设清理前是:
清理后变成:
两次请求从
C开始出现差异:
2
C' + D:不能继续复用原来这一段的计算结果你可能会问:D 的文字没改,为什么也要重新计算?
因为模型处理 D 时,会参考它前面的内容。原来参考的是完整工具结果 C,现在参考的是占位说明 C’,所以即使 D 的文字一样,它对应的中间计算结果也可能不同。
因此,你引用的这句:
从这条消息开始往后的内容都和上次不一样了。
更准确地说应该是:
从修改位置开始,后面的上下文计算条件变了,不能继续复用原有前缀的缓存,即使后面某些文字没变。
3. 那为什么还要清理?
这是一次取舍:
- 清理当下:可复用的旧前缀变短,部分输入需要重新处理。
- 后续请求:消息内容更短,处理负担减少;如果新的前缀保持不变,也可以再次被缓存。
所以清理不会让缓存永久失效。它是付出一次缓存复用减少的代价,换取后续上下文变短;如果因此避开了一次摘要调用,还能省去那次额外请求。
---------- 旧版本 ----------
PaiCLI 第二期做完 Plan-Execute 之后,有个问题一直让我很头疼——Agent 的记忆力跟金鱼一样,聊着聊着就忘了前面说过什么。
你跟它说“我喜欢用 JDK 17”,清空对话再来一轮,它又傻x地给你生成 JDK 8 的代码。
这期就来解决这个问题,给 Agent 加上完整的 Memory 系统。
短期记忆,管的是当前对话的上下文——用户说了啥、工具返回了啥、Agent 做了哪些决策。LLM 本身是无状态的,每次请求都是独立的,根本不记得上一轮聊了什么。短期记忆就是替它“记着”,下次输入的时候把历史消息一起带上。
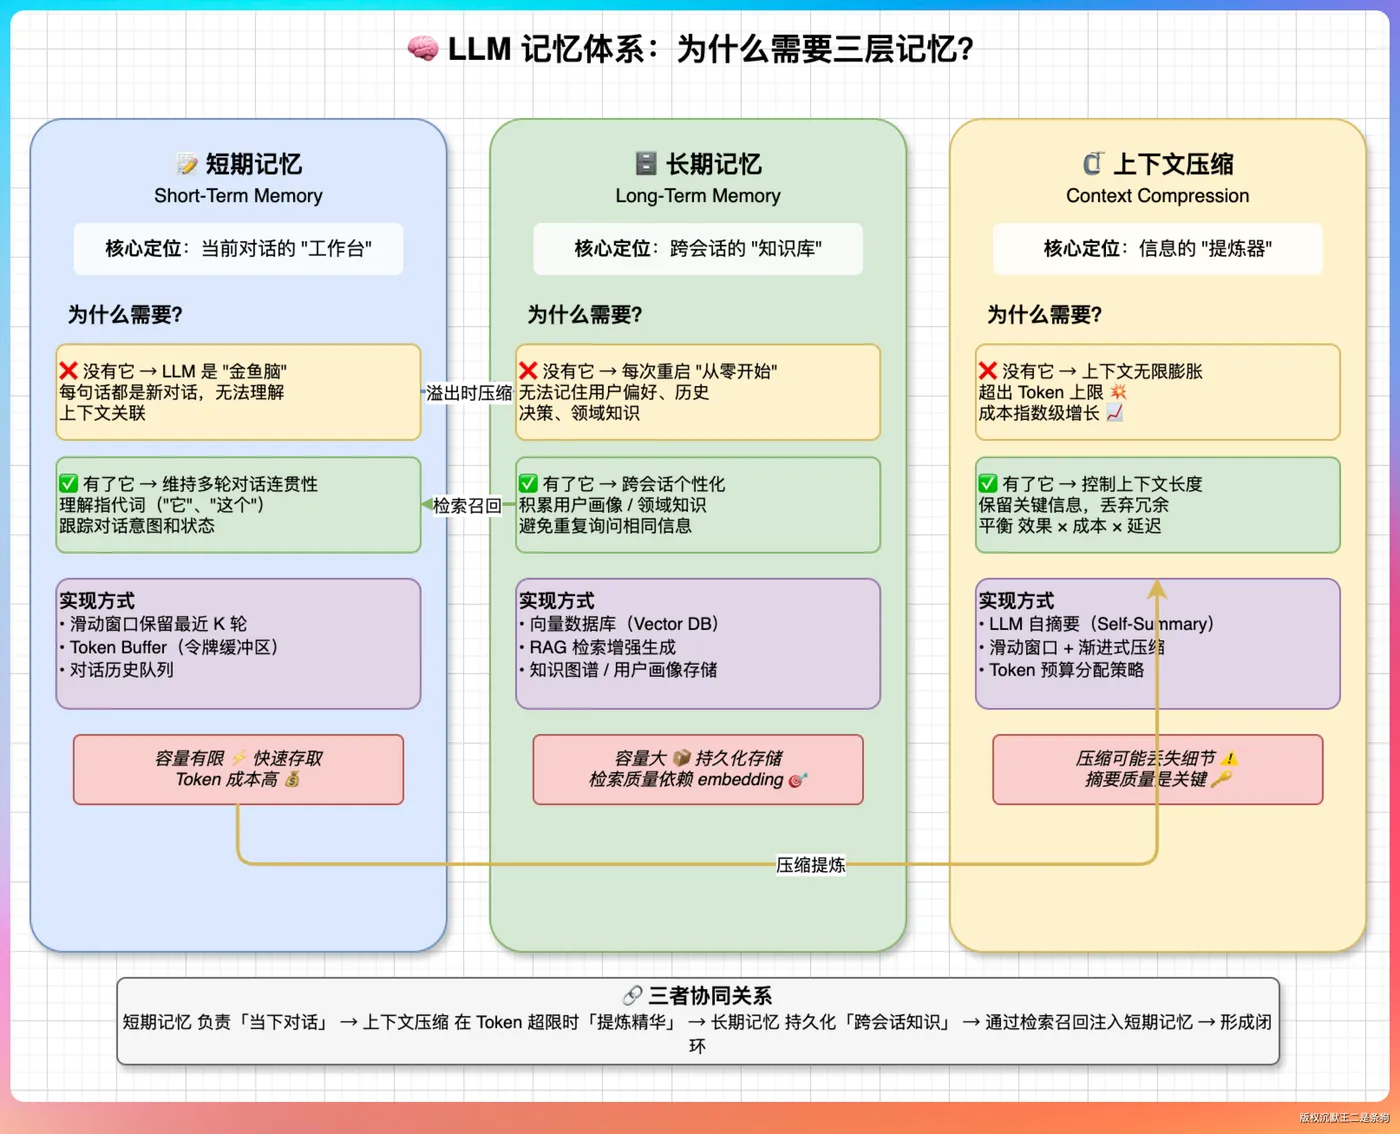
但短期记忆有个致命缺点——会话一关,全没了。下次启动 Agent,它完全不知道你之前的偏好、项目用什么技术栈、代码风格有什么约定。
所以得有长期记忆,把这些跨会话的关键信息持久化到磁盘上,不管开多少个会话窗口,Agent 都能记住。
所以需要上下文压缩——达到阈值就做摘要,保留关键信息,丢掉冗余细节。这样 LLM 才有足够的空间思考,手里拿到的也都是有用的上下文。
『提问』
MemoryManager 是怎么压缩上下文的?
我们现在把记忆管理和上下文压缩分开了。
MemoryManager负责长期记忆、相关记忆检索,以及上下文配置和 Token 统计。真正的压缩由 Agent 在调用模型前,通过AutoCompactionManager来协调,直接处理实际发给模型的消息列表。整体按成本从低到高分三步:
第一,单次工具结果太大时,先把完整内容存到文件,对话里只保留说明,需要时再读。
第二,对话达到较低的清理阈值时,把较早的工具结果正文替换成简短说明,保留工具调用 ID 和最近的结果,避免破坏工具调用与结果的对应关系。
第三,清理后仍达到摘要阈值,就调用模型总结较早的对话,保留系统提示词和最近几轮消息,用摘要替换旧对话。
阈值根据模型上下文窗口计算,会给摘要和后续回复留空间,不是固定超过 80% 就压缩。摘要失败、格式不合格,或者压缩后 Token 没减少,就保留摘要前的历史。原始消息另外保存在会话文件里。
如果面试官追问“为什么不在
MemoryManager里再存一份短期记忆”,可以补充:实际发送的消息列表就是短期上下文。 再维护一份副本,容易出现“压缩的是一份,发给模型的是另一份”的问题,所以直接在真实消息列表上清理和压缩。
1. Memory 的整体设计
这幅图与实际的代码设计不一致!
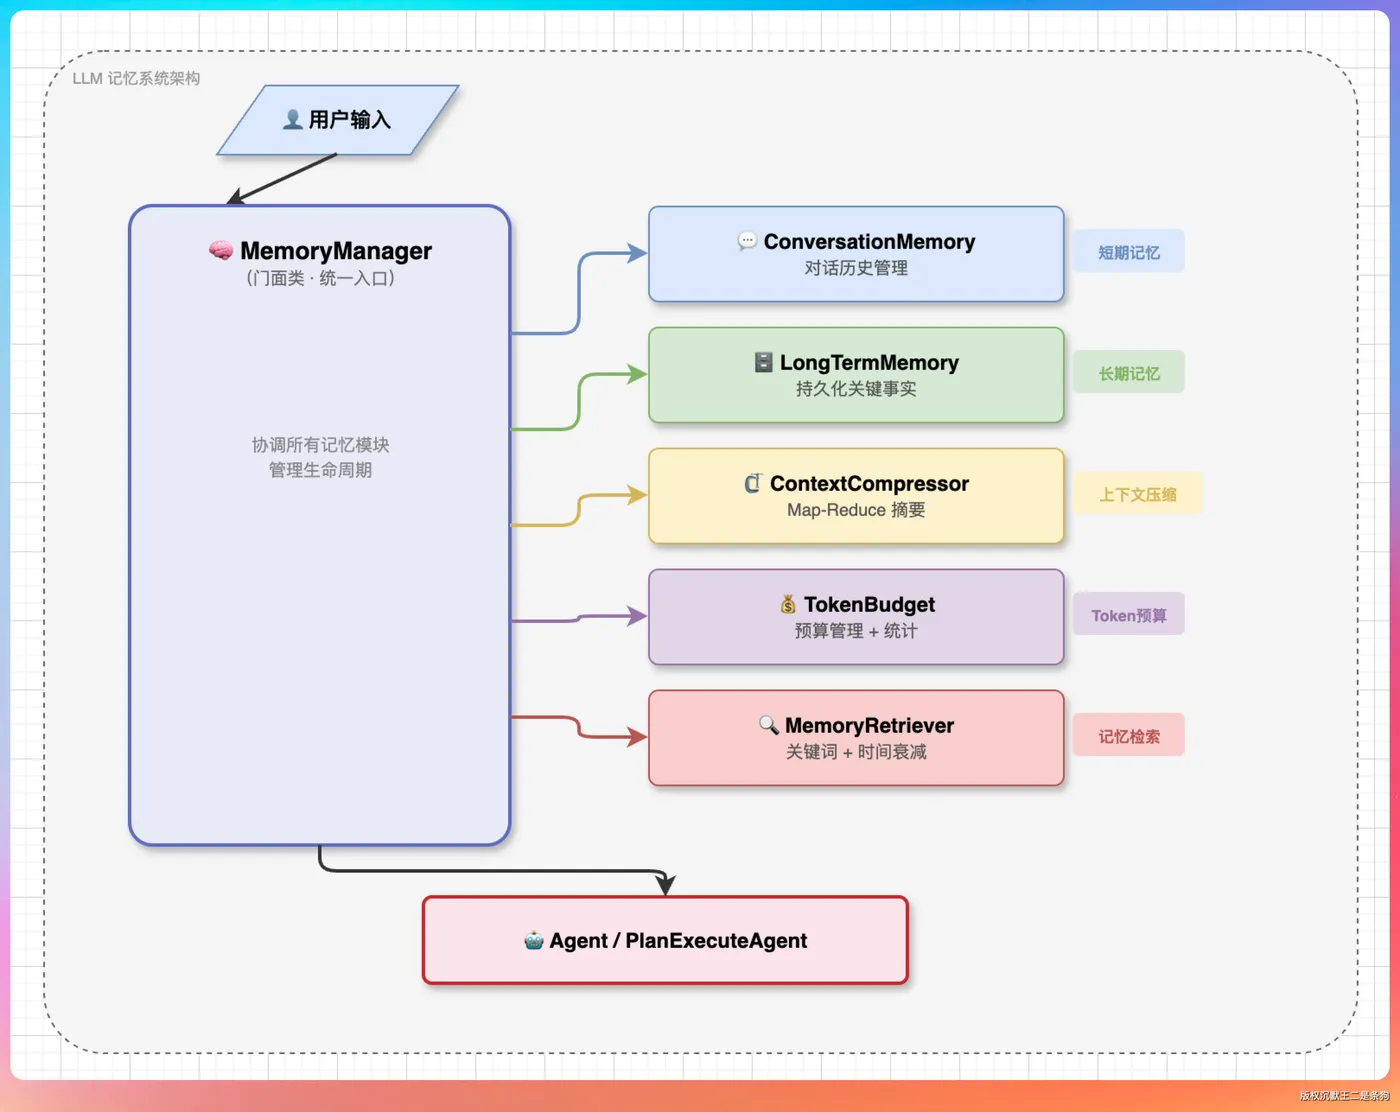
MemoryManager 是整个系统的门面,底下管着 ConversationMemory、LongTermMemory、ContextCompressor、TokenBudget、MemoryRetriever 五个组件。Agent 不用关心这些细节,对外就暴露两个操作——存消息、取记忆。存的时候自动管预算,取的时候自动检索相关上下文。
2. 记忆的基本单元
记忆不是一堆字符串往列表里塞就完事了。Agent 得知道每条记忆是什么类型——对话还是事实?
什么时候产生的——用来做时间衰减。
占多少 token——用来做预算管理。有没有附加信息——比如这条事实来自哪个项目。
所以每条记忆条目长这样:
1 | // src/main/java/com/paicli/memory/MemoryEntry.java |
- CONVERSATION 是对话消息,FACT 是用户偏好、项目信息这类关键事实,SUMMARY 是压缩后的摘要,TOOL_RESULT 是工具执行结果。
TOOL_RESULT 之所以单独分出来,是因为工具返回的内容通常特别长(比如读一个文件能返回几百行),但检索的时候又需要知道“之前执行过什么命令”。标记出来之后,压缩时可以对工具结果更激进地砍,对话内容则多保留一些语义。
token 估算也得有个方法,预算管理全靠它:
1 | // src/main/java/com/paicli/memory/MemoryEntry.java,estimateTokens 节选 |
中文约 1.5 字一个 token,英文约 4 个字符一个 token。精确计算得用 tokenizer。
3. 短期记忆 代码有问题
短期记忆干两件事:存消息和自动淘汰。
token 预算是有限的,聊多了总会撑满。这时候最简单的策略就是淘汰最旧的消息——跟操作系统的页面置换一个道理,内存不够了就把最久没用的页面换出去。对话是顺序的,最旧的消息通常最不重要,FIFO 就够了。
项目代码中没有实现 ConversationMemory 类
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
private final LinkedHashMap<String, MemoryEntry> entries;
private final int maxTokens;
private final AtomicInteger currentTokens;
private final List<MemoryEntry> compressedSummaries;
public void store(MemoryEntry entry) {
entries.put(entry.getId(), entry);
currentTokens.addAndGet(entry.getTokenCount());
// 超出预算时自动淘汰最旧的条目
while (currentTokens.get() > maxTokens && entries.size() > 1) {
evictOldest();
}
}
}被淘汰的消息不会直接扔掉,而是放进
compressedSummaries列表,等着后面压缩成摘要——信息还在,只是换了个更紧凑的形态。
getUsageRatio()返回当前 token 使用率,超过 80% 的时候 MemoryManager 就会自动触发 ContextCompressor 来做压缩。
项目有“上下文过长时自动压缩”的功能,但没有按上面描述的这套方式实现。 当前代码没有 compressedSummaries、getUsageRatio() 或 ContextCompressor。
两部分分别来看。
1. 旧消息是否先放进列表,等待压缩?
没有单独的待压缩列表。项目直接处理实际发给模型的 conversationHistory(对话消息列表)。
在 ConversationHistoryCompactor.java (line 150) 中:
1 | // 从现有历史中取出较早的消息 |
摘要生成成功且 Token 确实减少后,才替换原来的历史:
1 | history.clear(); |
替换后的结构大致是:
1 | 系统消息 + 历史摘要 + 最近若干轮对话 |
摘要是有损压缩,不能保证所有细节都保留。 原始消息另外由 ConversationLedger(会话记录类)追加保存到磁盘,不会因上下文压缩而被删除。
2. 是否超过 80% 就由 MemoryManager 自动触发?
不是固定 80%,也不是 MemoryManager 主动触发。
实际由 Agent 在调用模型前执行,例如 Agent.java (line 542):
1 | int trigger = memoryManager.getContextProfile().compressionTriggerTokens(); |
其中 AutoCompactionManager 是协调清理和压缩的类:先清理旧工具结果,仍达到阈值时再尝试摘要压缩。
阈值由 ContextProfile.java (line 83) 按模型窗口计算:
1 | 压缩阈值 = 上下文窗口 − 摘要空间预留 − 压缩缓冲 |
例如窗口为 128,000 Token 时:
1 | 128,000 − 20,000 − 13,000 = 95,000 |
也就是约 74.2% 时达到摘要触发阈值,而非固定 80%。
所以,描述当前项目时可以改成:
Agent 在调用模型前检查对话长度,先清理旧工具结果,必要时把较早对话压缩成摘要,并保留最近的对话。压缩阈值根据模型上下文窗口计算,原始消息另存于会话记录文件。
4. 长期记忆
短期记忆跟着会话走,对话一关就没了。但有些信息是跨会话都需要的——“用户喜欢 JDK 17”“项目用 Maven 构建”——这些东西得存到磁盘上,下次启动 Agent 还能用。
1 | // src/main/java/com/paicli/memory/LongTermMemory.java |
这里有三个设计点值得说一下。
首先是自动去重,用户连续三次说“我喜欢用 Java”,长期记忆里不会存三遍,内容相同的直接跳过。
然后是即时持久化,每次 store 都调 saveToDisk,写入 ~/.paicli/memory/long_term_memory.json。存储路径支持三种配置——默认路径、JVM 参数 -Dpaicli.memory.dir=/path、环境变量 PAICLI_MEMORY_DIR,方便测试环境和生产环境隔离。
最后是启动时加载,Agent 启动的时候自动把之前的记忆读进来。加载时会保留原始时间戳,这一点很重要——如果时间戳被覆盖成当前时间,后面做时间衰减检索的时候,旧记忆就不会被正确衰减了。
检索这块,用了 『jieba 分词器』做中文优先的轻量匹配。“项目技术栈”能正确切成“项目”“技术”两个词,命中率比单纯的字符串 contains 高不少。
1 | // src/main/java/com/paicli/memory/MemoryQueryTokenizer.java |
jieba 在 Java 生态里算比较成熟的中文分词库了。分完词后还会过滤掉单字和纯标点——中文里 “的” “了” “是” 这种单字基本没有检索价值,留着只会带来噪音。
search 方法调用分词器,同时匹配内容line6 和 metadataline 9:
这里的 search 主要在你手动搜索记忆时调用,例如:
调用链是:
2
3
→ MemoryManager.searchLongTerm(query, 20)
→ LongTermMemory.search(query, 20, currentProject)需要区分:普通提问时自动给模型补充相关记忆,走的是
MemoryRetriever(记忆检索器)的相关度评分流程,并不调用这个search方法。
1 | // src/main/java/com/paicli/memory/LongTermMemory.java |
MemoryRetriever 里的 computeRelevanceScore 也是用 jieba 来算关键词匹配度的。
不过说实话,jieba 分词加关键词匹配跟『向量检索』比起来还是差了一截。“Java 框架”匹配不到“Spring Boot”,这种语义层面的理解需要 Embedding 才能搞定,我们放到第四期。
5. 上下文压缩
这块是整个 Memory 系统里我觉得最有意思的部分。短期记忆满了,旧消息得淘汰,但关键信息不能丢。怎么办?压缩成摘要,再注入回去。
压缩策略用的是『Map-Reduce』,跟处理大文档的思路一样:
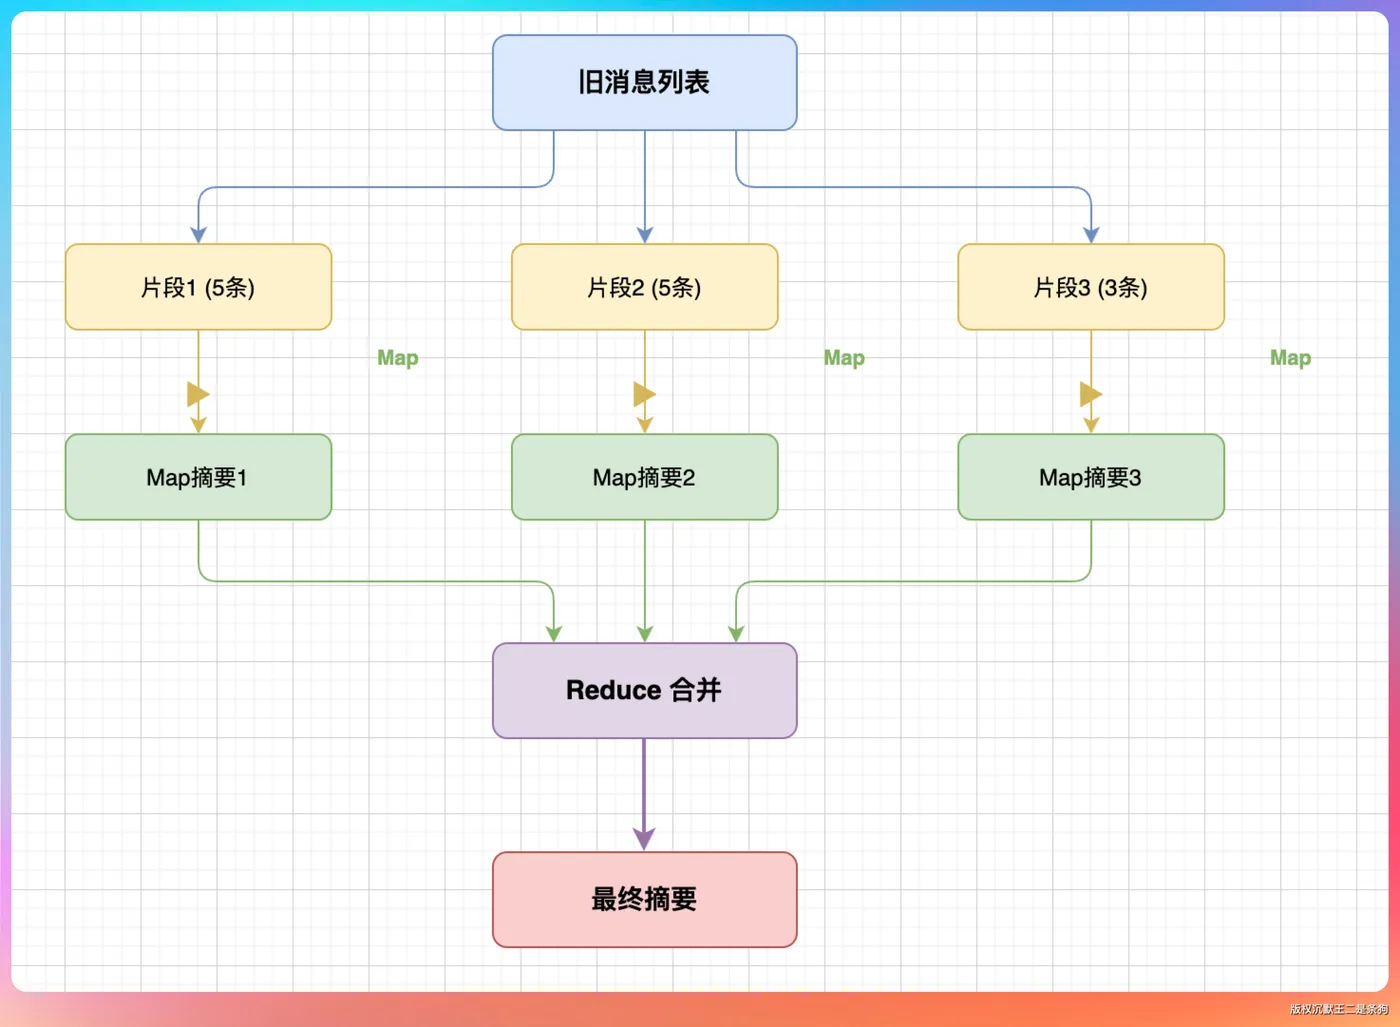
Map 阶段:把旧消息分成每 5 条一组,每组独立调用 LLM 生成摘要。分组处理比一股脑扔几十条给 LLM 效果好得多,模型处理短文本的摘要质量明显更高。
Reduce 阶段:把多个分片摘要合并成最终摘要。只有一片的话直接用,不再多调一次 LLM。
下面 compress 方法不存在,
1 | public String compress(ConversationMemory memory) { |
retainRecentRounds 这个参数很关键——最近 3 轮消息不参与压缩,原样保留。刚聊的内容通常是当前任务的核心上下文,压缩可能会丢掉关键细节。
ContextCompressor 还干了一件事:事实提取。对话结束的时候,调用 extractFacts 让 LLM 从对话里提炼关键信息——用户偏好、项目配置、重要决策——自动塞进长期记忆。
与项目中
src/main/java/com/paicli/memory/AutoFactExtractor.java的 extractFacts 方法实现不同。
1 | public List<String> extractFacts(List<MemoryEntry> entries, |
比如用户说了句“我喜欢用 Spring Boot”,下次启动 Agent 的时候,这条偏好已经在长期记忆里等着了,不用再重复说一遍。
6. Token 预算管理
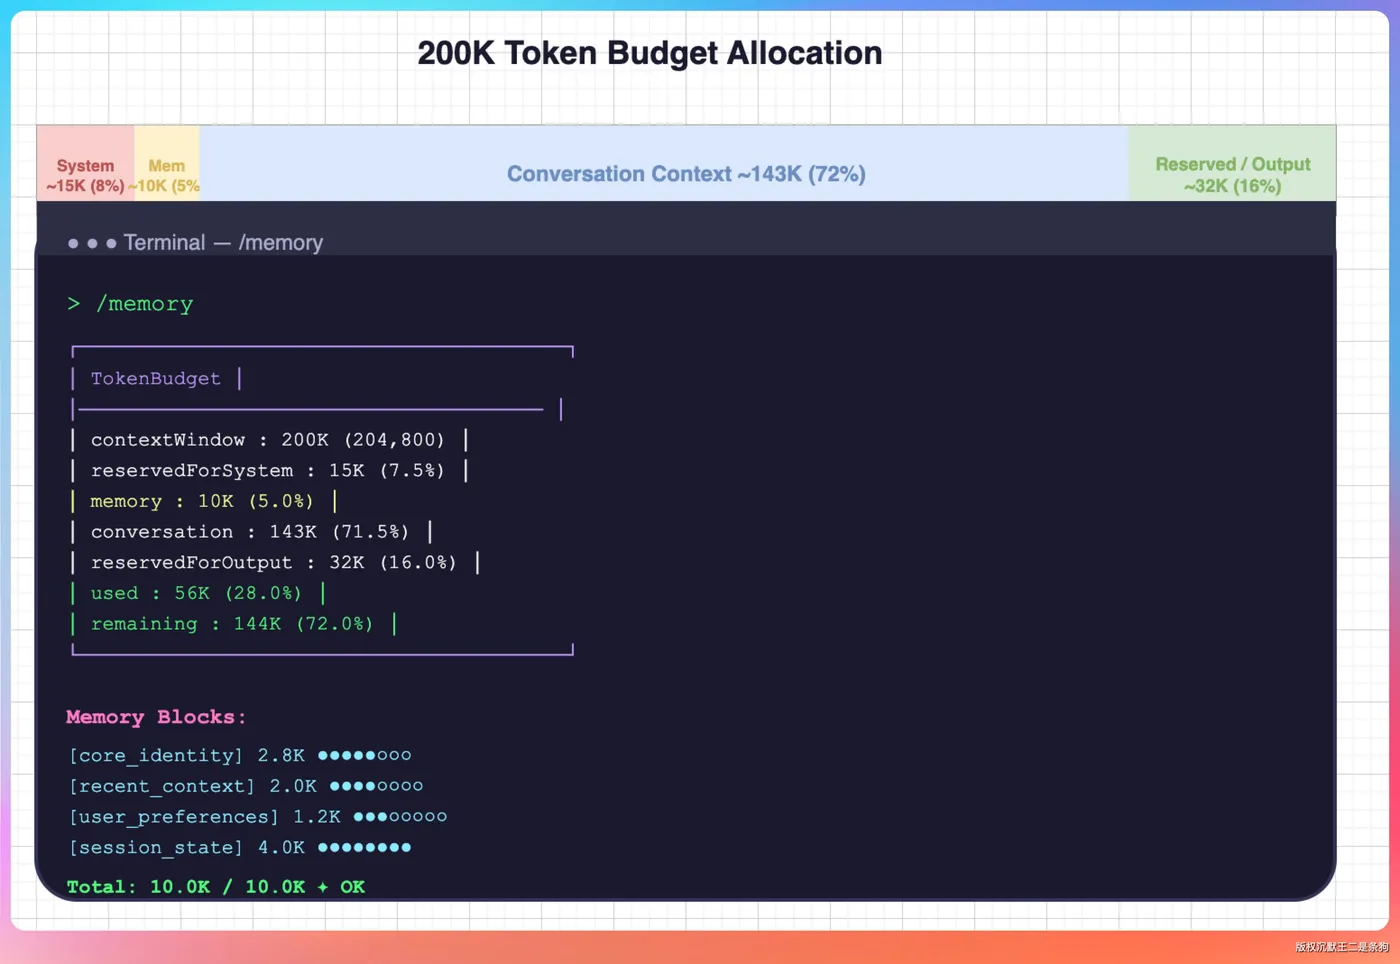
这玩意儿不是一个简单的计数器,而是一个预算分配器。
模型的上下文窗口就那么大,GLM-5.1 是 200K。但这 200K 不能全给对话历史用,系统提示词要占一块,工具定义要占一块,模型生成回复也得留出空间。
1 | // src/main/java/com/paicli/memory/TokenBudget.java |
对话历史超过 80% 预算就触发压缩。留 20% 余量是因为 token 估算本身就不精确(我们用的是字符数估算,不是真正的 tokenizer),卡太死容易翻车。
TokenBudget 还顺带记录了每次 LLM 调用的 token 消耗,调试的时候很好用:
1 | // src/main/java/com/paicli/memory/TokenBudget.java |
在 CLI 里输入 /memory 就能看到完整的状态报告。
7. 记忆检索
短期记忆和长期记忆都有了,但 Agent 处理新输入的时候,不能把 100 条记忆全塞给 LLM——大部分跟当前任务根本不沾边,纯属浪费 token。
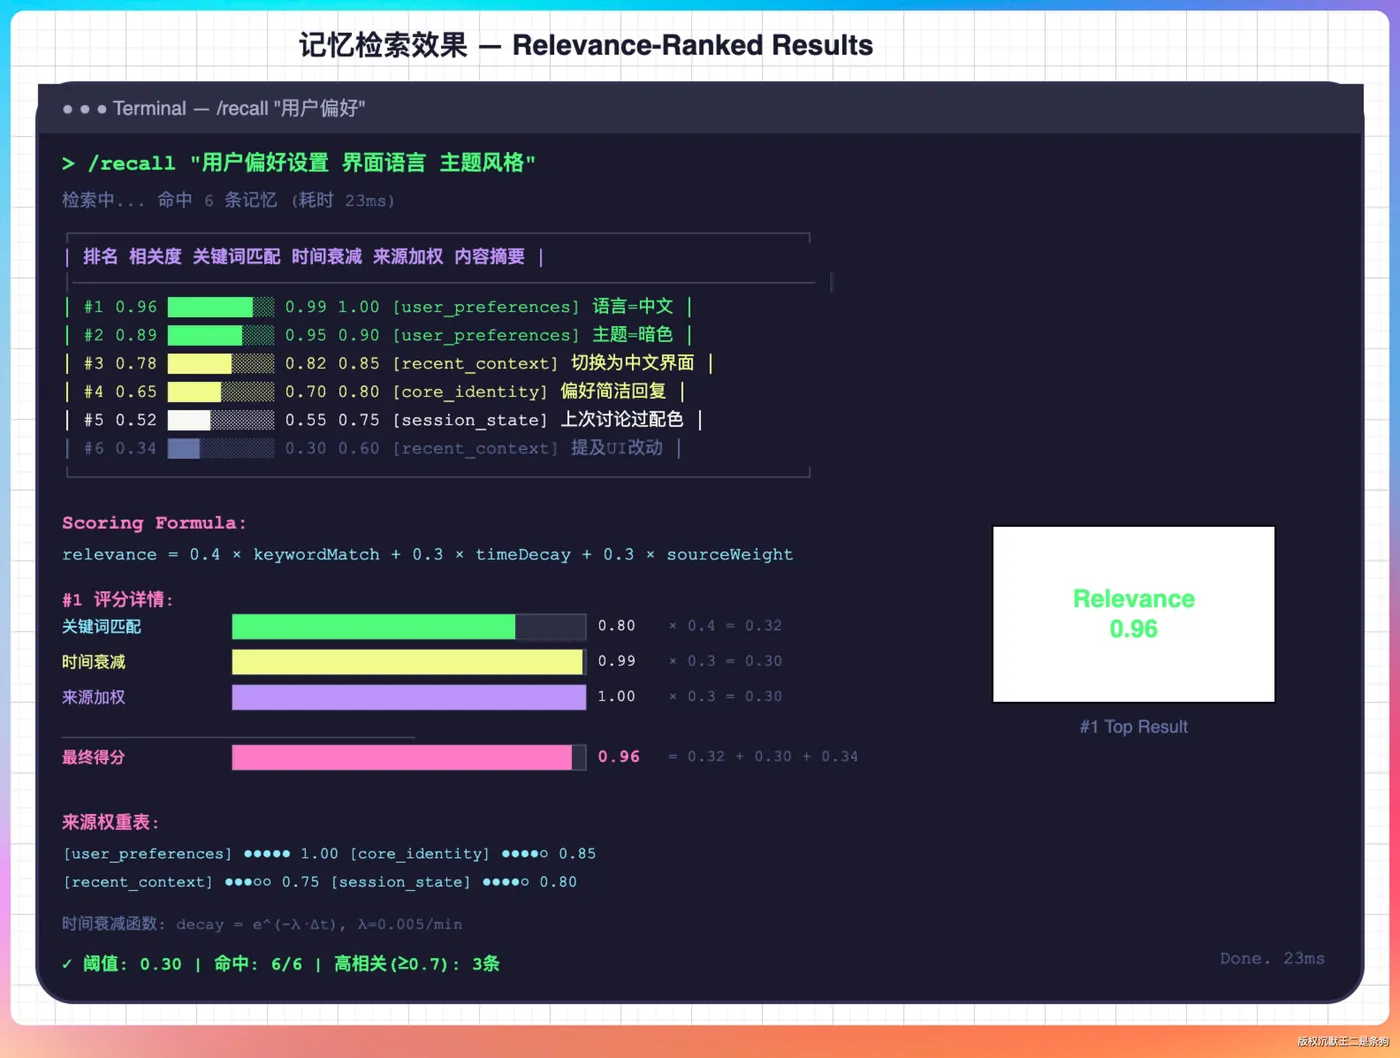
MemoryRetriever 干的就是从两层记忆里把最相关的条目捞出来。
项目代码中仅从长期记忆中检索稳定事实,用于 system prompt 注入。
因为短期对话本来就会发给模型,再把它检索出来作为“相关记忆”注入,会重复,而且容易把临时请求误当成长期事实。
1 | // src/main/java/com/paicli/memory/MemoryRetriever.java,retrieve 节选 |
相关度计算考虑了三个维度:关键词匹配——把查询分词后逐词匹配,命中越多分数越高;时间衰减——24 小时内从 1.0 线性衰减到 0.5,三天前的旧事权重自然就低了;来源加权——长期记忆的条目是经过提取和精炼的,信息密度更高,给 1.2 倍权重。
检索结果通过 buildContextForQuery 拼成文本,注入到 LLM 的输入里。Agent 那边改动很小,构建消息时带上记忆上下文就行。
8. 集成到 Agent
组件都写好了,接下来把它们插到 Agent 和 PlanExecuteAgent 里。核心改动在 Agent.run 方法:
1 | // src/main/java/com/paicli/agent/Agent.java,runInternal 节选 |
用户输入进来,先存短期记忆,再从长期记忆里捞相关上下文,注入到 system prompt,然后正常走 ReAct 循环。
这里有个细节——记忆上下文是注入到 system prompt,不是拼到 user message 里。如果塞到 user message,LLM 可能把记忆内容当成用户的指令来执行,这就乱套了。放到 system prompt 里,模型会把它当背景信息参考,不会跟用户输入混淆。
1 | /** |
工具结果:加入对话历史,同时写入会话文件
1 | // [Agent.java 第 284 行 (line 284)](paicli/src/main/java/com/paicli/agent/Agent.java:284): |
助手最终回复:同样保存到两处
1 | // Agent 回复后 |
工具结果和助手回复会加入当前对话上下文,并追加保存到会话记录文件;任务结束时累计统计 Token 消耗。它们不会因此自动成为长期记忆。
用户输入 /clear 后,清空当前对话上下文,重建基础系统提示词,并记录本次清空操作。已经保存的长期记忆保持不变,磁盘上的原始会话记录也不会被删除。
1 | /** |
PlanExecuteAgent 也做了类似的集成。执行每个 Task 的时候注入长期记忆上下文,LLM 就能参考之前的项目信息做决策。执行完整个计划后,自动提取关键事实到长期记忆,不用等用户手动 /clear。
CLI 也新增了两个命令:/memory 查看记忆系统的完整状态,/save 事实内容 手动保存关键事实到长期记忆。
9. MemoryManager
1 | public class MemoryManager { |
compressIfNeeded 是自动触发压缩的关键——每次存消息后检查 token 使用率,超过 80% 就调 ContextCompressor。Agent 代码里只管存消息,压不压缩、怎么压缩,全是 MemoryManager 内部的事。
门面模式的好处就在这里。如果没有 MemoryManager,Agent 得自己管短期记忆、长期记忆、压缩时机、token 预算……代码会乱成一锅粥。
extractAndSaveFacts 也值得提一句。对话结束的时候(用户输入 /clear 或者直接退出),它会自动从当前对话里提取关键事实存入长期记忆,全程不需要用户操作。当然,用 /save 事实内容 手动保存也行,有些信息用户自己知道是重要的,主动存更靠谱。
示例中的代码 当前实现 ConversationMemory shortTermMemory没有这个字段,改由 Agent 的 conversationHistory保存LongTermMemory longTermMemory第 27 行 (line 27),保存跨会话的长期记忆 ContextCompressor compressor没有这个字段,压缩由 Agent 调用 AutoCompactionManager完成MemoryRetriever retriever第 28 行,负责检索相关长期记忆 TokenBudget tokenBudget第 31 行,负责 Token 预算和消耗统计;当前不是 finaladdUserMessage(...)没有这个方法,消息由 Agent 直接加入对话历史 buildContextForQuery(...)第 225 行 getSystemStatus()第 250 行
Multi-Agent TODO
RAG 代码检索
用 SQLite + Embedding 给 Agent 加上 RAG,从此秒懂项目源码!
这一期我们来给 Agent 装上 RAG,让 Agent 可以直接读我们的代码库。
- 举个具体场景,我问“MemoryManager 是怎么压缩上下文的”。没有 RAG 的 Agent 只能凭训练数据瞎猜,猜得对算运气好。
装了 RAG 之后,Agent 会先去代码库里捞 ContextCompressor.compressIfNeeded,看 Map-Reduce 的实现,再基于这段真实代码的回答。
当前代码没有实现
ContextCompressor。压缩由 Agent 调用AutoCompactionManager完成。Agent.java (line 542)
2
3
4
int trigger = memoryManager.getContextProfile().compressionTriggerTokens();
autoCompactionManager.compactIfNeeded(conversationHistory, trigger);其中
AutoCompactionManager是协调清理和压缩的类:先清理旧工具结果,仍达到阈值时再尝试摘要压缩。
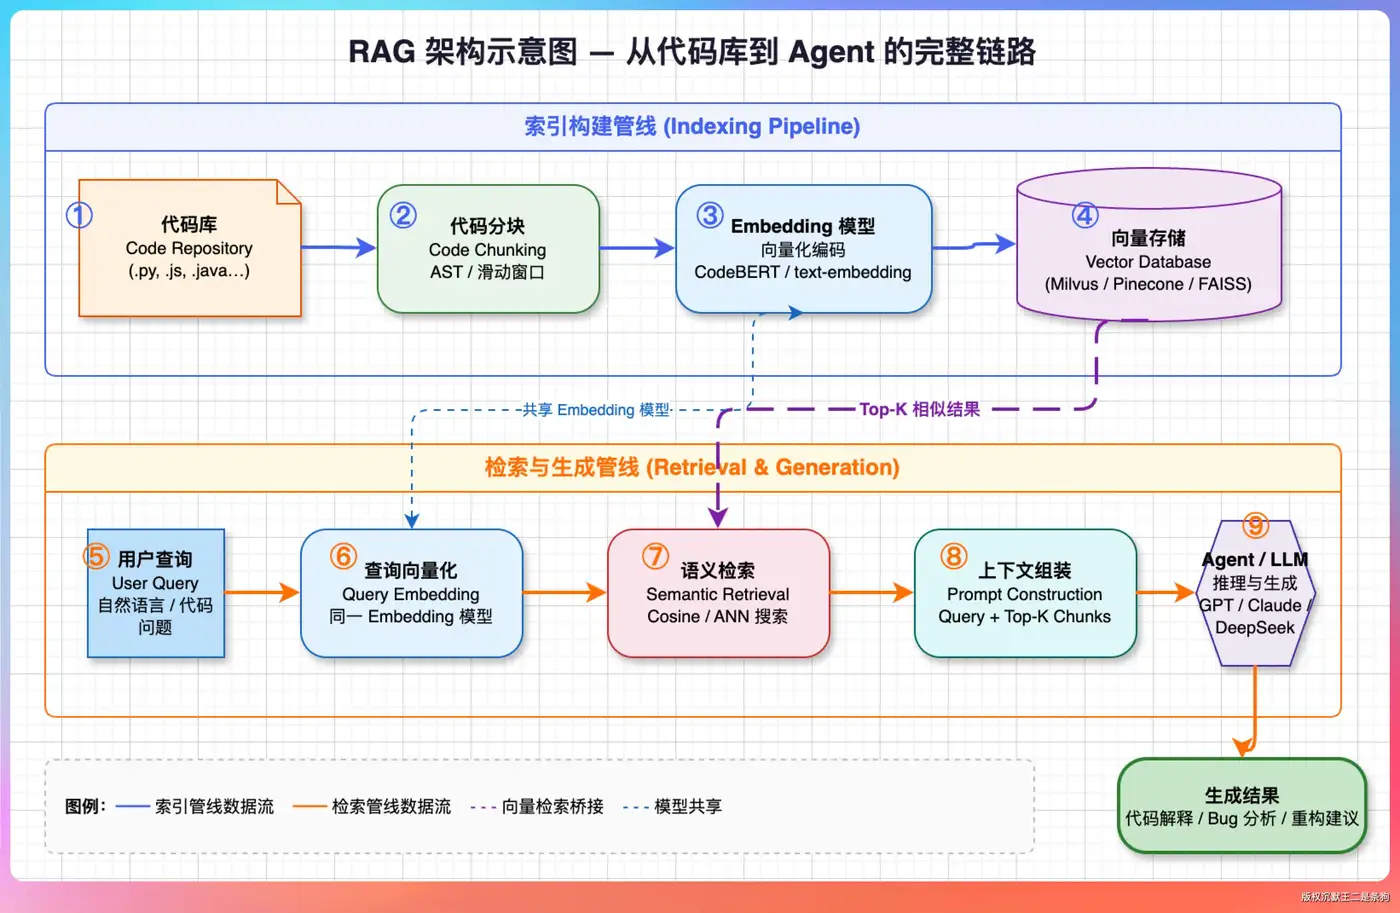
整个 RAG 的架构示意图如下所示。
『提问』
向量数据库为什么选用 SQLite 而不是其他的?
- PaiCLI 面向本地开发场景,我们选择 SQLite 保存代码块和向量,在 Java 中计算余弦相似度,减少用户部署和运维成本。当前方案的主要限制是逐条比较;如果未来扩展成多人共享服务,会根据实际向量规模、并发和召回率要求,对比 pgvector、Qdrant、Milvus 等方案后再迁移。
向量数据库的选型指标:
数据规模:看向量条数、维度和总存储量,不能只看代码行数。
访问方式:单人本地使用,还是多人共享、高并发查询和写入。
检索要求:是否需要关键词融合、复杂过滤、多租户隔离。
性能目标:用相同数据和查询比较
召回率、P95 延迟、写入速度和资源消耗。近似检索用索引换取速度,也要检查是否漏掉相关结果。
召回率看“相关内容找回来多少”’,召回率 = 找回的相关结果数量 ÷ 实际相关结果总数;
P95 延迟看“大多数查询能在多久内完成”;
还常用 Recall@K 衡量近似检索是否漏掉真正最近的向量
2
3
4
近似索引返回的前 5 个:A、B、C、F、G
Recall@5 = 3 ÷ 5 = 60%维护成本:是否已有 PostgreSQL、Elasticsearch 等基础设施,团队能否维护额外服务。
1. RAG 的整体设计
RAG 工作流程:把知识库向量化然后持久化到向量数据库,查询的时候,按照语义相似度找出最相关的片段,再连同问题一起塞给 LLM。
落到代码场景,有三个问题绕不开。
第一个是怎么切。代码不像文档,按字数硬切会切出很多噪音。最稳妥的办法是按结构特征切——文件级、类级、方法级,检索时按粒度匹配。
第二个是存到哪。生产环境通常上 Milvus、Pinecone 、ElasticSearch 这种专用向量库。但我们是个 CLI 工具,这些都太重量级了。所以我这里选择了 SQLite。
第三个是怎么样才能搜得准。纯向量检索对自然语言友好,对代码标识符却不一定。
所以我们这里做了混合检索——语义打底、关键词加权、再按 chunk 类型加分。method 块比 file 块优先级高,因为用户问“怎么实现的”,给方法体比给整个文件有用得多。
举个例子,搜“处理用户登录的地方”,它能定位到
LoginService.authenticate。
整个 RAG 模块拆成 10 个类,下面一块一块讲。
1 | CodeChunk —— 代码块数据模型 |
2. AST 解析
代码分块是 RAG 里最容易被低估的一步。分得好,检索准;分得糙,后面再多加权也救不回来。
Java 文件和非 Java 文件得分开处理。
Java 走 AST (抽象语法树),按类和方法切;非 Java(比如 Markdown、yaml)就按字符大小切,每段控制在 2000 字符以内。
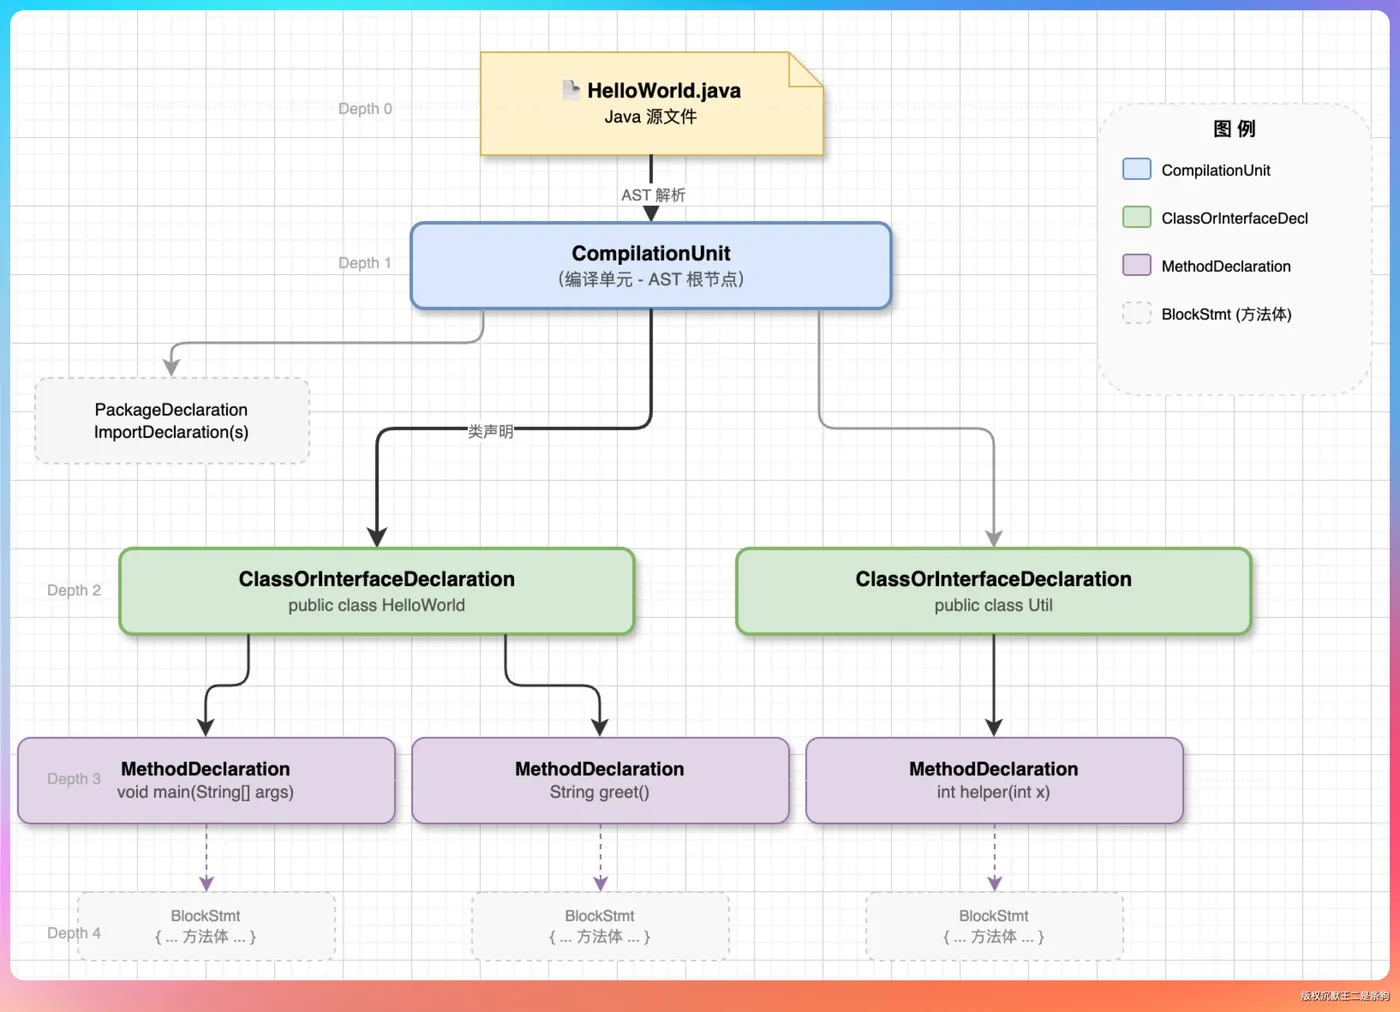
Java 这块用 JavaParser,CodeChunker 里的核心逻辑是这样:
1 | // src/main/java/com/paicli/rag/CodeChunker.java,chunkFile 节选 |
JavaParser 可以把语言级别设到 JAVA_17,text block、record、sealed class 这些新语法都能正常解析。
万一遇到语法错误,可以自动回退到按大小分段,不会因为一个文件解析失败就漏掉整块代码。
非 Java 文件超过 2000 字符就生成一个 chunk,同时把起止行号一起带上。检索结果直接能跳到对应行,不用二次定位。
Java 这边类级和方法级各存一份。
类级只保留类声明和前 5 行(字段、签名这些信息够用了),不用把几百行的类全塞进去;方法级则把完整方法体捞出来,单独成块。
1 | // src/main/java/com/paicli/rag/CodeChunker.java,chunkJavaFile 节选 |
CodeChunk 用的是 record,除了正文内容,还带了文件路径、块类型、名称、起止行号。
toEmbeddingText 方法会把这些拼成 [method:Agent.run] public String run(...) 这种格式再去算向量,让模型一眼看清这是哪个类的哪个方法。
1 | // src/main/java/com/paicli/rag/CodeChunk.java |
CodeIndex 是整个索引流程的入口,把“遍历文件 → 分块 → 向量化 → 持久化”封装进去。
外面只要一行 codeIndex.index("/path/to/project") 就能跑起来。
遍历用的是 Files.walkFileTree,node_modules、target、.git、build 这些目录直接跳过,文件类型也只挑常见的源码后缀。
3. Embedding
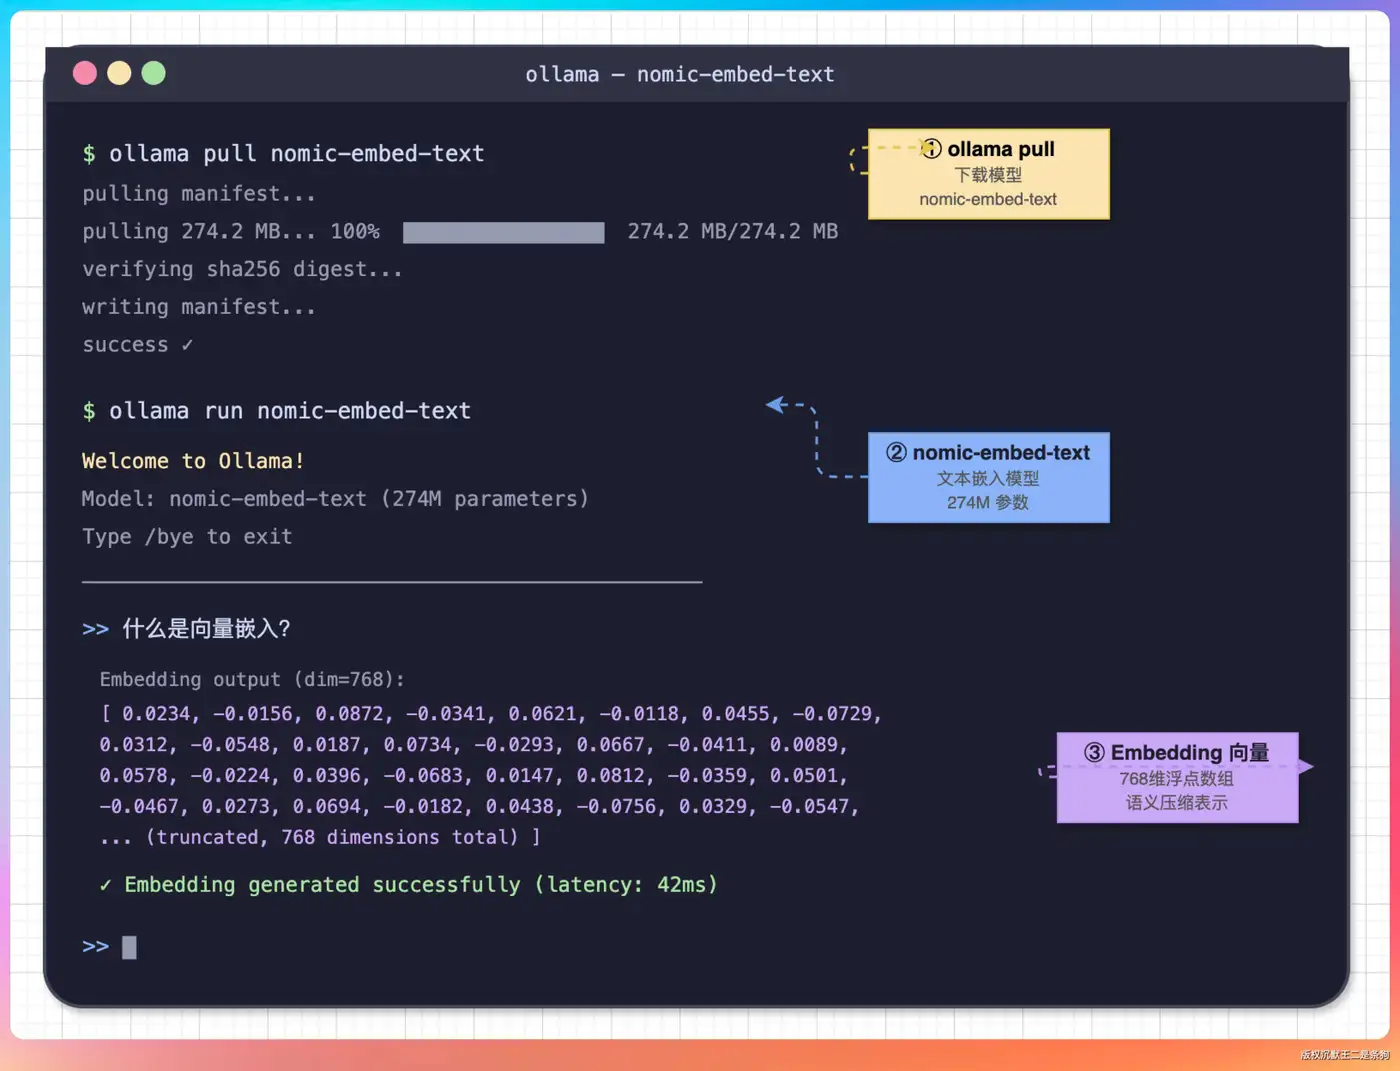
切完块就该生成向量了。EmbeddingClient 支持两种方式。
-
默认走 Ollama 本地模型,免费、断网也能跑,本地装个 Ollama 拉一个 nomic-embed-text 就能开干。
![image]()
切换不用改代码,环境变量配一下就行:
1
2
3export EMBEDDING_PROVIDER=ollama
export EMBEDDING_MODEL=nomic-embed-text:latest
export EMBEDDING_BASE_URL=http://localhost:11434 -
机器扛不动的话,再切到远程 API——智谱、阿里千问都 Embedding 模型。
切到智谱的话:
1
2export EMBEDDING_PROVIDER=glm
export EMBEDDING_API_KEY=your_key_here
embed 方法按 provider 分发——Ollama 走 /api/embeddings,OpenAI 兼容的走 /embeddings,请求体和响应解析在内部处理过了,外面只负责传文本,拿向量。
1 | // src/main/java/com/paicli/rag/EmbeddingClient.java |
MAX_INPUT_CHARS 卡在 2000,中文密集的文本大概对应 4000~6000 token,喂给 8192 上下文的模型绰绰有余。超出的部分直接截断,省得 API 抛错。
响应格式两家也不一样。
Ollama 把向量放在 embedding 字段,是平铺数组;OpenAI 兼容格式塞在 data[0].embedding 里。
在客户端里统一转成 float[],上层就不用知道底下是哪一家。
HTTP 超时给得比较宽松,连接 30 秒、读取 120 秒。Ollama 首次加载模型会比较慢,远程 API 一般几秒就回,120 秒覆盖两边都足够用。
4. 向量存储
向量存哪?Milvus、Weaviate 太重了。一个 CLI 工具,让用户先起个 docker、配个端口、再装一堆 SDK 才能跑,谁顶得住。最后选了 SQLite。
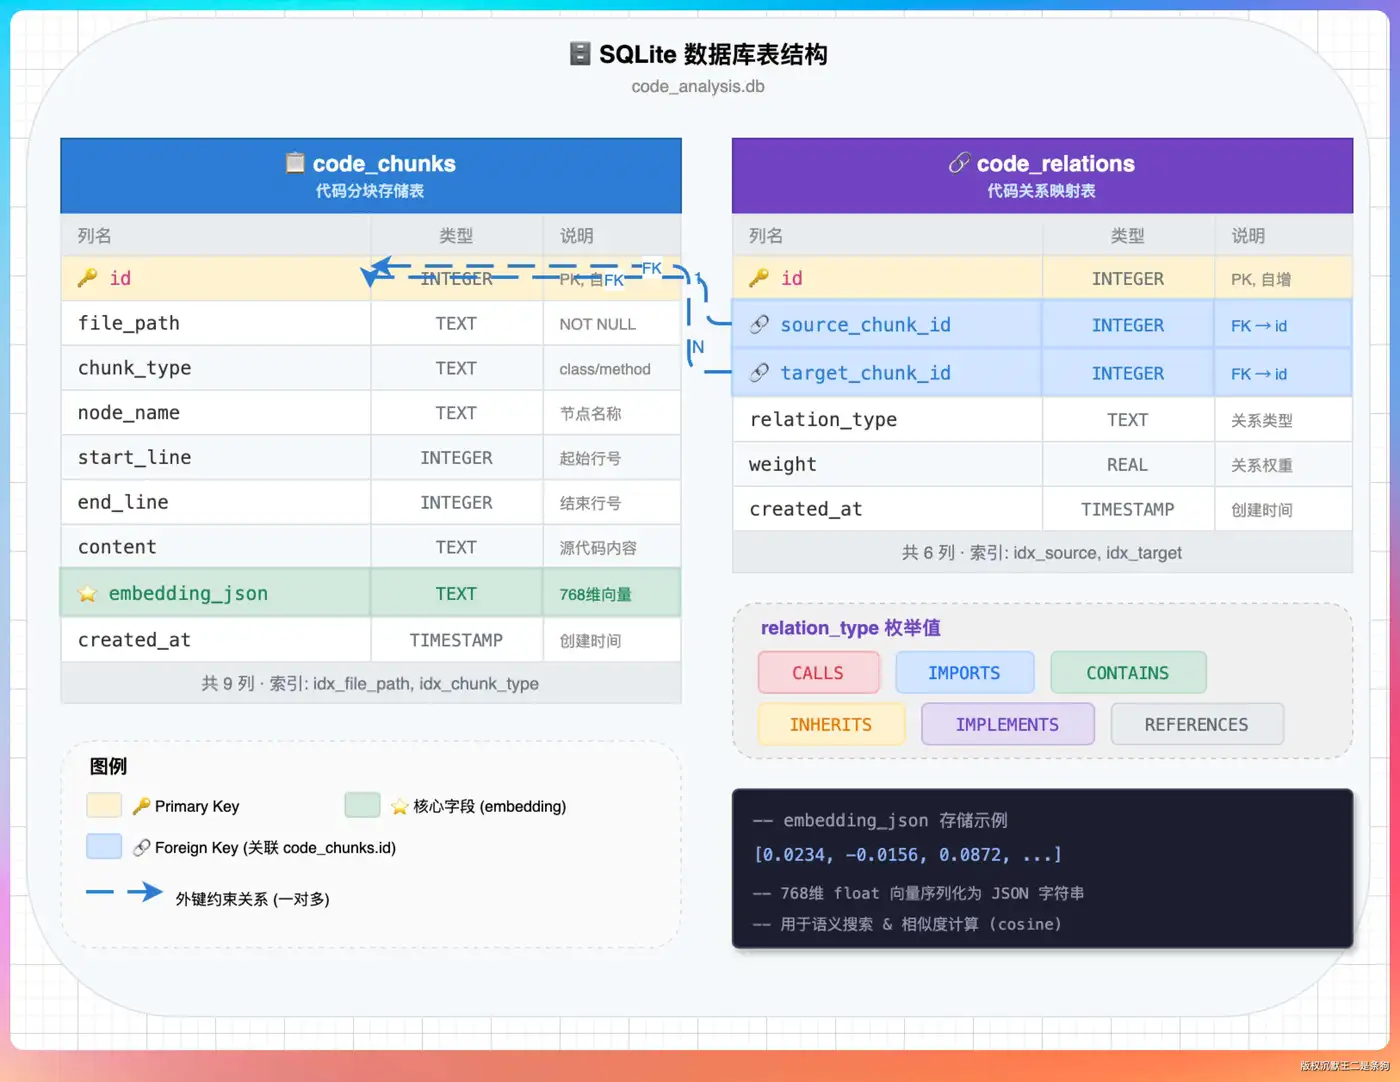
向量以 JSON 数组形式塞到 TEXT 字段里,检索时全量读到内存,逐条算余弦相似度,排序取 TopK。
可能有小伙伴犯嘀咕:全部读到内存,能扛得住?
我自己跑下来——常见的个人项目也就几百到几千个代码块,768 维的向量,1000 块大约 3MB 内存,单次检索几十毫秒。
这个量级根本不用上专用向量库,等哪天真撑不住了再换也不迟。
1 | // src/main/java/com/paicli/rag/VectorStore.java,search 节选 |
VectorStore 除了向量检索,还顺手把关键词检索和关系图谱查询都做了。
关键词走 LIKE,专门用来精确命中类名/方法名;关系图谱单独一张表,存 extends、implements、imports、calls、contains 这五种关系,后面查调用链就靠它。
批量插入这块加了事务保护。先关掉 autoCommit,最后 batch 一把提交,中间挂了就 rollback。
索引也得老老实实建。project_path、file_path、chunk_type 这几个常用维度都覆盖到,关系表的 from_name 和 to_name 也加上。SQLite 再轻量,几千条数据上没索引的 LIKE 也能卡死。
向量序列化用的是 Jackson,float 数组直接转成 JSON 字符串塞到 TEXT 字段。
可能有小伙伴想问为啥不用 BLOB,理由很简单——JSON 调试方便。打开数据库可视化工具就能看到一行行的向量值,定位问题不用再写脚本反序列化。
- BLOB 是 Binary Large Object 的缩写,意思是“二进制大对象”,是数据库中用来保存原始字节数据的类型,例如图片、文件内容,也可以保存向量。
- 特点:更紧凑,但需要按约定解码才能查看数值。
余弦相似度也没调任何第三方库,手撸循环,点乘除以两个模长,几十行就完事。
数据库文件默认放在 ~/.paicli/rag/codebase.db,所有项目的索引共用这一个文件,靠 project_path 区分。
一个项目一个库管起来反而麻烦。要换位置,给个 paicli.rag.dir 系统属性就能改。
5. 混合检索
纯向量检索有个老毛病——对同义词和语义相近的表达很灵敏,对精确的代码标识符反而没那么准。
比如搜“Agent 的 run 方法”,向量检索可能给你返回一堆带“Agent”“run”上下文的块,但偏偏不是那个方法。
CodeRetriever 的 hybridSearch 干了三件事来补这个短板。
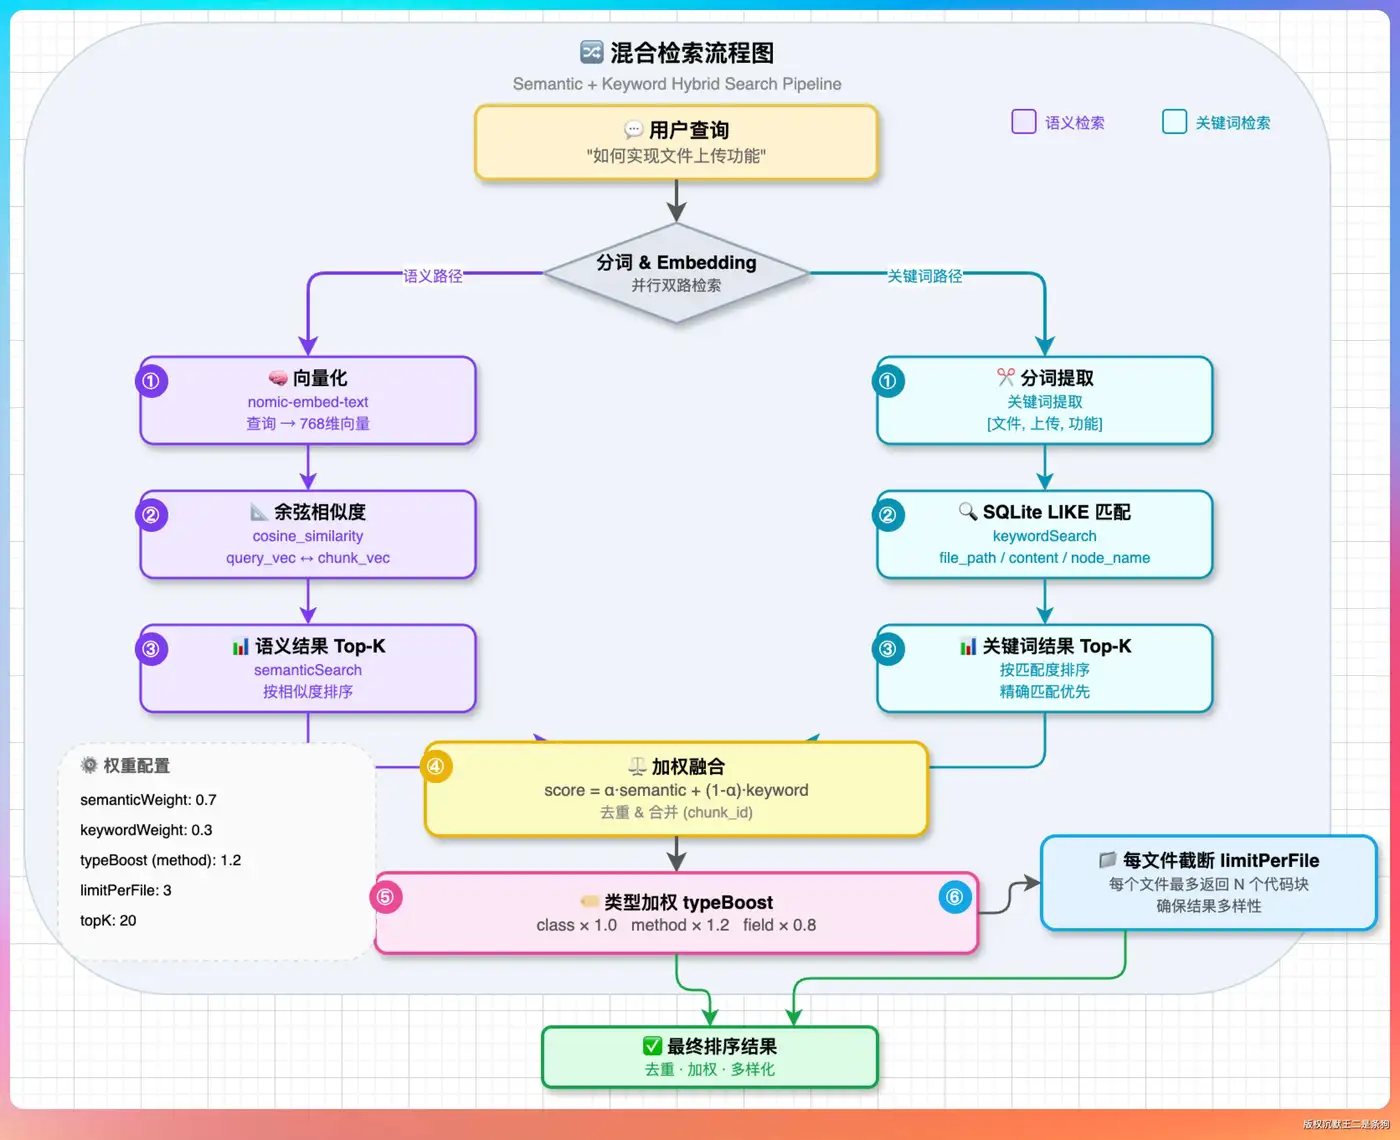
第一件,语义检索打底。 把查询向量化,跟库里所有向量算余弦相似度,先把语义最近的一批捞出来。
第二件,关键词加权。 用 jieba 把查询切词,挑出“Agent”“run”“ReAct”这类代码关键词,再用 LIKE 去库里扫一遍。
命中的结果按命中位置给不同分——类名/方法名命中 +0.3,文件路径命中 +0.1,内容命中 +0.1。命中的位置越关键,分数越重,跟 ES 那一套 BM25 加权思路差不多,只是更轻量级。
第三件,类型加分。 method 块 +0.15,class 块 +0.1,file 块不加。理由很简单,用户问“怎么实现”的时候,给方法体比给整个文件有用得多。
1 | // 代码类型加分 |
RagQueryTokenizer 也值得拎出来说两句。
它用 jieba 做中文分词,同时保留 ASCII 标识符(类名、方法名里的英文)。
分块完会过滤掉单字符和“怎么”“如何”“一下”这种没检索价值的停用词。
这样一来,“用户登录怎么实现”这种自然语言查询,“ReAct”“Agent”“MemoryManager”这种纯英文标识符也能保留。
还有个小机制叫双重命中奖励。
同一个块如果语义检索和关键词检索都命中了,额外 +0.1。相当于多个维度互相印证,分数当然要高一档。这个奖励只给一次,不叠加,避免某个块因为蹭中好几个关键词就霸榜。
最后再加一道同文件去重,每个文件最多保留 2 条。不然遇到一个特别大的文件,能把整个结果页都占满,diversity 就没了。
1 | // com/paicli/rag/CodeRetriever.java |
6. 代码关系图谱
检索到代码块只是第一步。
要真正读懂一个项目,得知道“这个类继承了谁、实现了哪些接口、它的方法又调了谁”。
CodeAnalyzer 用 JavaParser 做 AST 遍历,五种关系一起处理:extends(类继承)、implements(接口实现)、imports(依赖导入,只记非 JDK 的)、contains(类含方法)、calls(方法调用,简化版只记方法名)。
1 | // com/paicli/rag/CodeAnalyzer.java,extractClassRelations 节选 |
imports 这块做了过滤,只记非 java. 和 javax. 开头的。
calls 这块稍微费劲一点。
JavaParser 遇到 MethodCallExpr 节点之后,得往上回溯找到它属于哪个方法。CodeAnalyzer 里写了个 findParentMethod,沿着 AST 父节点一路往上爬,碰到 MethodDeclaration 就停。
没有这一步,只能知道“某个地方调了 chat”,但说不清是 Agent.run 调的还是 PlanExecuteAgent.executeTask 调的。
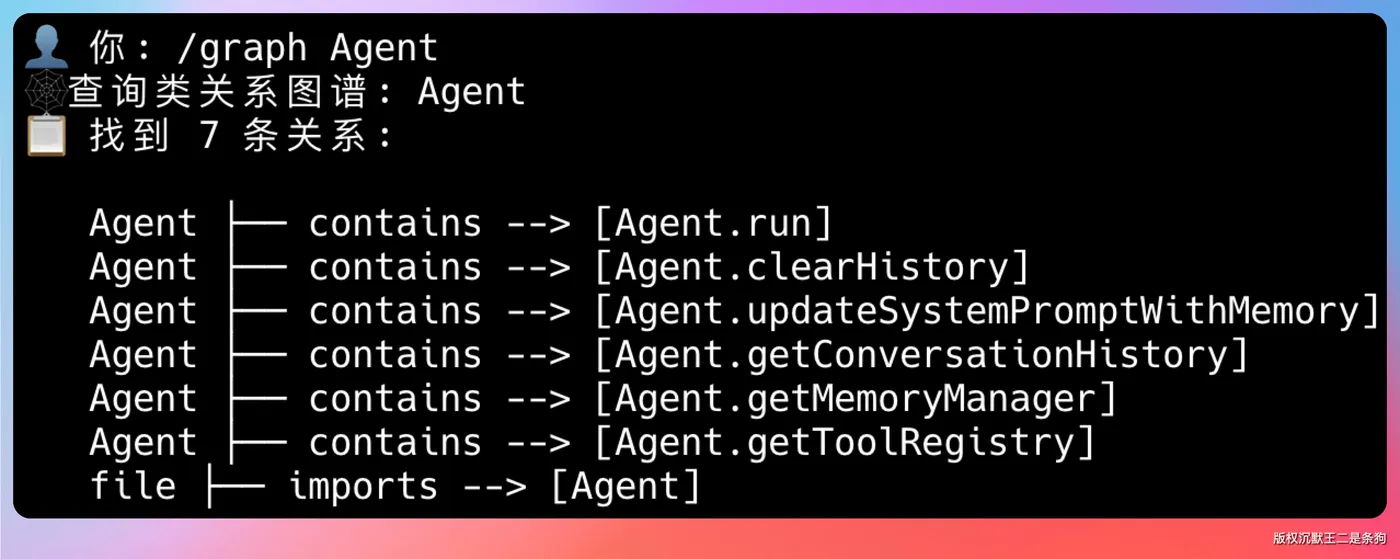
提取出来的关系全部塞进 SQLite 的 code_relations 表。CLI 里通过 /graph 命令就能查。比如 /graph Agent:
1 | Agent ├── contains --> Agent.run |
扫一眼就明白:Agent 继承自 BaseAgent,挂着一个 run 方法,run 内部调了 chat 和 executeTool。
7. 集成到 Agent
RAG 模块写好了,但 Agent 不会自己主动用。
得在 ToolRegistry 里注册一个 search_code 工具,告诉 LLM——遇到代码库相关的问题,调这个就行。
1 | // com/paicli/tool/ToolRegistry.java,registerRagTools 节选 |
同时把 Agent 的系统提示词也更新了一下,明确告诉 LLM:
1 | // src/main/resources/prompts/ |
这里有个特别容易翻车的细节——ToolRegistry 里的 projectPath 默认取 user.dir,但用户可能用 /index 索引了另一个目录。
如果不同步,工具检索的还是老路径,搜出来都是空的。所以 Main 里 /index 执行完之后,会立刻把索引路径同步给 ToolRegistry,确保两边对齐。
SearchResultFormatter 把搜索结果整理成人能看的样子。
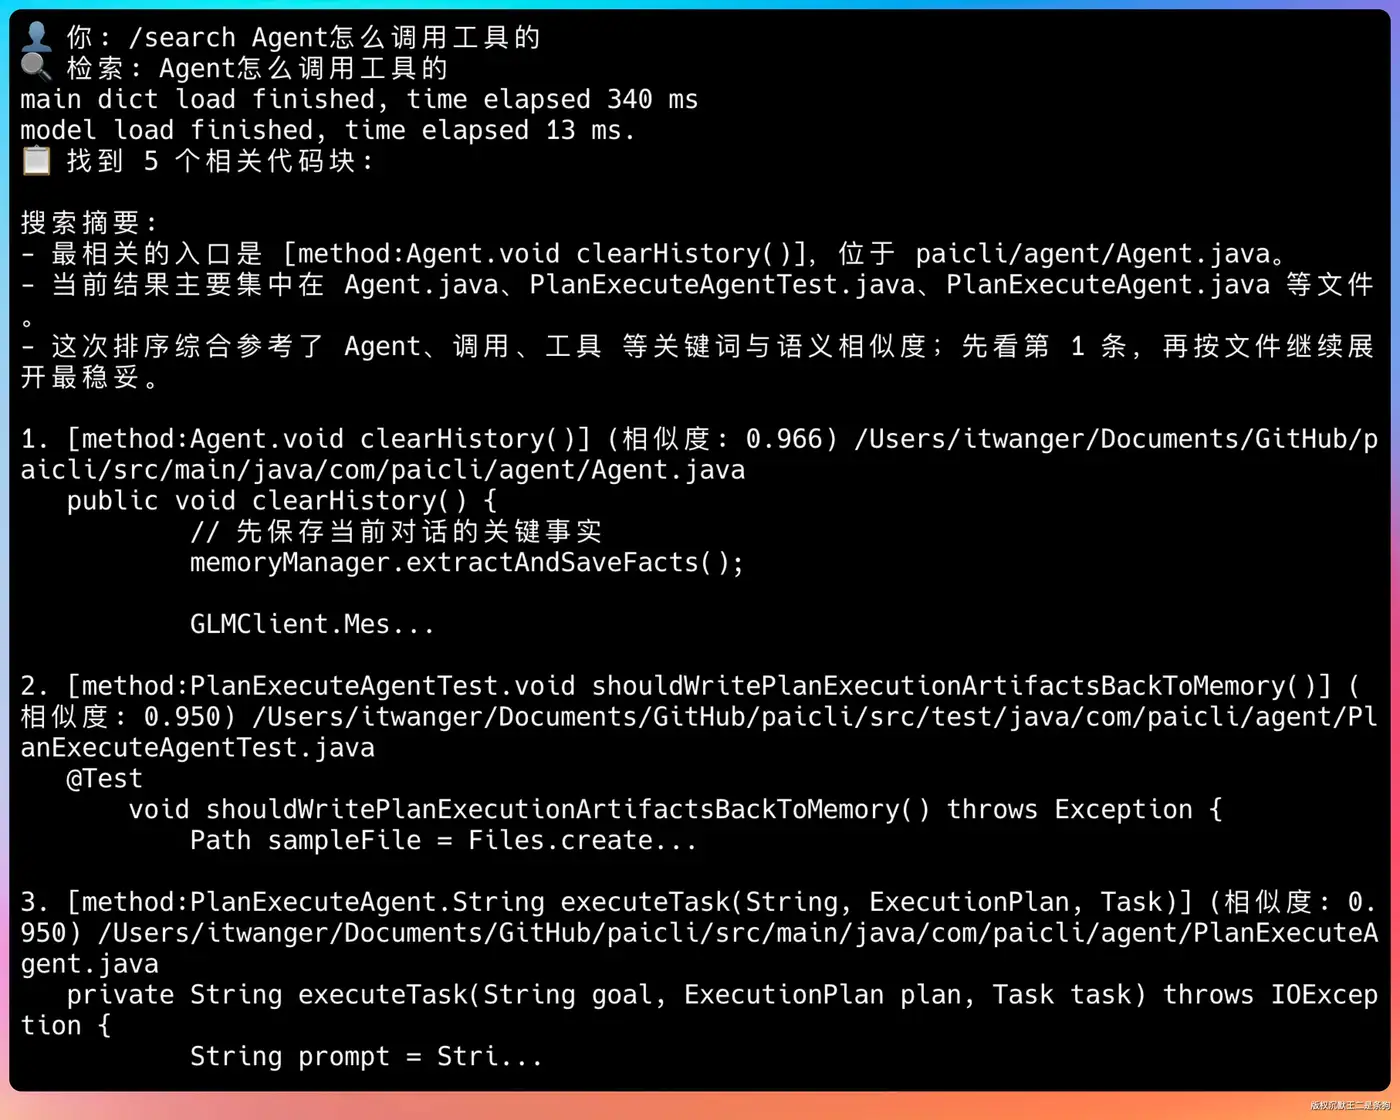
它有两个输出模式:formatForCli 给命令行用,带 emoji 和缩进;formatForTool 给 LLM 用,更紧凑,包含一段搜索摘要加带行号的代码片段。
摘要里会告诉模型 “最相关的入口是哪个方法” “结果主要集中在哪些文件” “排序综合参考了哪些关键词”,让 LLM 能快速判断该重点看哪几条。
PlanExecuteAgent 的执行提示词也加了类似的引导,规划任务里凡是涉及代码理解的步骤都会自动触发检索。这样不管是 ReAct 还是 Plan-and-Execute,两种模式都能看懂代码库。
8. CLI 实战
RAG 这一堆功能,最后通过三条 CLI 命令交到用户手上。
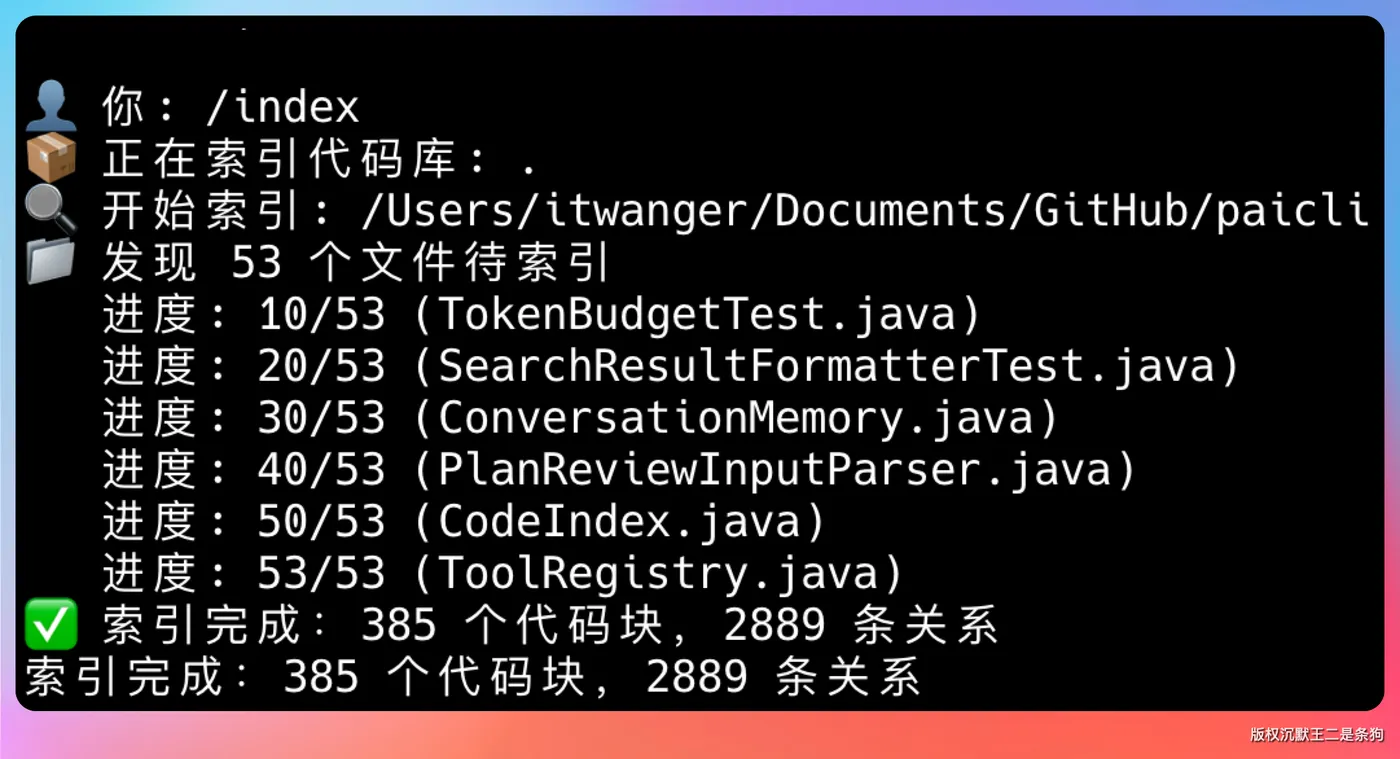
第一条是 /index,给代码库建索引。执行的时候它会遍历项目目录(node_modules、target、.git 这些自动跳过),每个文件分块、向量化、塞 SQLite。
第二条是 /search,用自然语言检索代码。不用记类名、不用记文件名,跟问同事差不多。
第三条是 /graph,查类或方法的关系图谱。
1 | 👤 你: /graph Agent |
/index 也支持指定路径,比如 /index /Users/xxx/my-project,可以索引任意目录的代码库。
索引过程每 10 个文件打一次进度,单个文件解析失败只会打 warn,不会中断整体流程。
最后再输出一行统计——多少代码块、多少条关系,一眼就知道这次索引的质量怎么样。